
Teraは、データおよびAI業務のために開発されたTeradataの自律型AIコワーカーです。私たちは、大規模データウェアハウスには従来とは根本的に異なるエージェントが必要であるという強い確信のもと、Teraを開発しました。そして驚くべきことに、この新しいアプローチによるエージェントは、データ業務だけでなく、あらゆるタスクにおいて優れた性能を発揮することが実証されました。
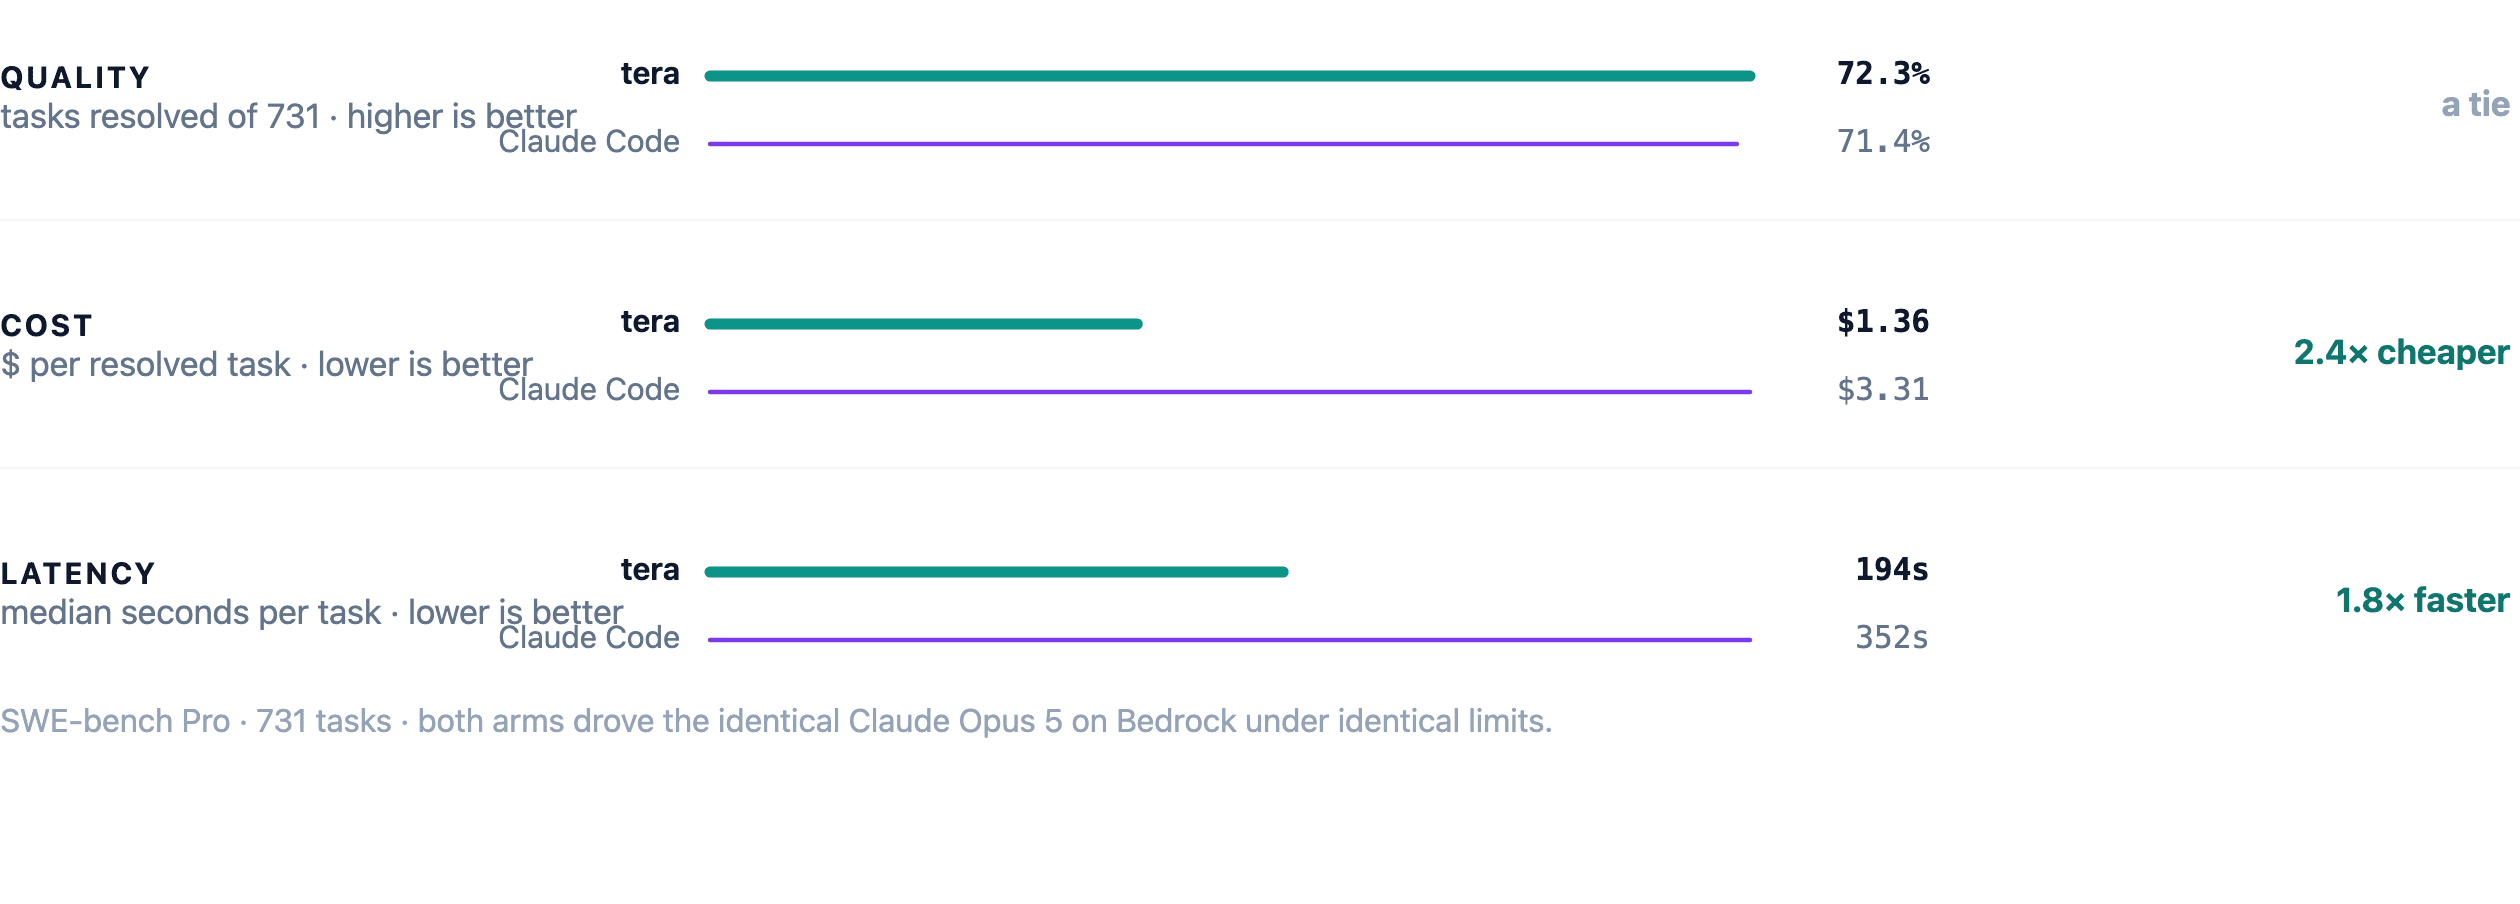
本レポートでは、業界の基準(ベースライン)と位置付けられているAnthropicのClaude Codeを対象に、4つの公開ベンチマークで実施した測定結果を報告します。同一のタスク、同一の制限、同一のモデルでの検証です。そのすべてのベンチマークにおいて、TeraはClaude Codeと同等以上の精度を維持しながら、約半分のコスト、約半分の所要時間(経過時間)で同一の業務を完遂しました。
本レポートでは、なぜ自社製ハーネスを構築せざるを得なかったのか、データ領域で培った規律がなぜデータ以外の領域でも重要となったのか、そして各数値がどのように導き出されたのかについて詳述します。
Teradataが自社製ハーネス(実行制御基盤)を構築した理由
現在、あらゆる企業が同一の限られた選択肢から最先端のフロンティアモデルを調達しています。そのため、モデルを取り巻く「ハーネス」(どのようなコンテキストを入力するか、どのツールへアクセスできるか、回答を提示する前にどう検証するか、いつ作業完了と判断するか)こそが真の差別化要因となります。そして、これこそがデータチームが直面する最大の壁でもあります。汎用のコーディングエージェントは、たとえSQLにどれほど精通していても、本番データウェアハウスの環境には耐えられません。
Teradataの領域はデータ業務であり、データはコーディングエージェントが前提としている前提条件を根底から覆します。
- 誤った数値も一見正しく見えてしまう:コーディングなら「ほぼ正しい」コードはテストで失敗します。しかしクエリの場合、「ほぼ正しい」クエリでも数値が返ってきてしまいます。例えば、VARCHARとCHARを結合(Join)した際、末尾の空白(trailing spaces)によって行の40%が警告もなく脱落しても、ダッシュボードに表示される売上数値は一見もっともらしく、正しい数値と区別がつきません。エラーは発生せず、テストも検知できず、レビュアーも見落とします。発覚するとしても、何週間も後の取締役会資料の中です。
- 失敗が致命的(壊滅的)な影響を及ぼす:探索型のエージェントは、1回の調査で誰も監視していない中で100ものクエリを並列実行することがあります。そのすべてが本番インフラに対する直接的なアクションです。探索そのものが実行であるため、最後にレビューする工程など存在しません。途中で不用意な抽出条件(述語)を1つ挟むだけで、そのウェアハウス上の全ユーザーのシステムを停止させてしまいます。
- エージェントのコンテキストに収まらない:スキーマすら収まりません。1行のデータを読み込む前に、数千ものテーブルが存在します。データ自体も収まりません。いかに莫大な予算があっても10億行を読み切ることは不可能です。エージェントがデータを理解するために実行したクエリ結果すら、それ単体でコンテキストウィンドウを超過します。コードリポジトリならコストを払えば最初から最後まで読み込めますが、データウェアハウスは誰であっても丸ごと読み込むことは不可能です。エージェントは問い合わせる前に何を要求すべきかを把握し、かつそれが正しくなければなりません。
- アクセス制御は単なる設定値ではない:個人を特定できる情報(PII)は対話ログに混入してはなりません。認証情報はセッションログに残してはなりません。行レベルのアクセス権限は、最終的に返される回答だけでなく、エージェントが行うすべてのアクセス動作に適用されます。コーディングエージェントが自身のログにシークレットを漏洩させれば「インシデント」で済みますが、データエージェントがそれを犯せば「情報漏洩(データ侵害)」になります。
これらが相まって、エージェントが動作すべき厳格な行動基準を決定づけます。コーディングエージェントは、環境側が誤りを正してくれる(ビルドが失敗する、テストでアラートが出る、コードレビューでコミットが弾かれる)ため、不注意であることが許容されます。それらは苦労せず得られる無料の修正です。しかしデータの世界にはそれらが一切存在しないため、エージェント自身がその規律を担わなければなりません。
これこそが私たちがTeraを開発した目的です。エラーの発生頻度を下げ、影響範囲を小さく抑え、失敗する際は迅速に失敗させることです。
私たちが予期していなかったのは、この規律がデータ以外の領域でも効果があることです。不慣れなコードベース、数十ファイルに及ぶ変更など、ウェアハウスとは無縁の一般的なソフトウェアエンジニアリングで測定したところ、Teraは最高水準のエージェントと同等の品質を維持し、コスト面では大幅に低減しました。Teraの設計において、その結果を意図したものは一切ありませんでした。
そこで私たちは、自社が所有しない4つのベンチマークを用い、自社が制御できないテストによって評価される、4種類のエンタープライズワークロードを厳密に測定しました。
今回測定した内容
私たちは4つの公開ベンチマークを選定し、Teradataのお客様が対価を支払って依頼する業務から、私たちが本来対象としていなかった業務への順序で検証を実施しました。
data-eng-bench—Snowflake Labs
Snowflake LabsおよびBespoke Labsによって作成されたdata-eng-benchは、私たちの日常業務に最も近いテストです。合成された小売データウェアハウス上で構築・修正される103件のdbt変換モデルタスクで構成されています。採点はpytestによりタスクあたり27個のアサーションで判定され、すべてのアサーションに合格した場合のみ合格とみなされます。3回に1回しか動作しないパイプラインは納品されたとは言えないため、すべてのタスクは3回実行され、3回の試行すべてが成功することを必須とする「Pass³」を記録しています。
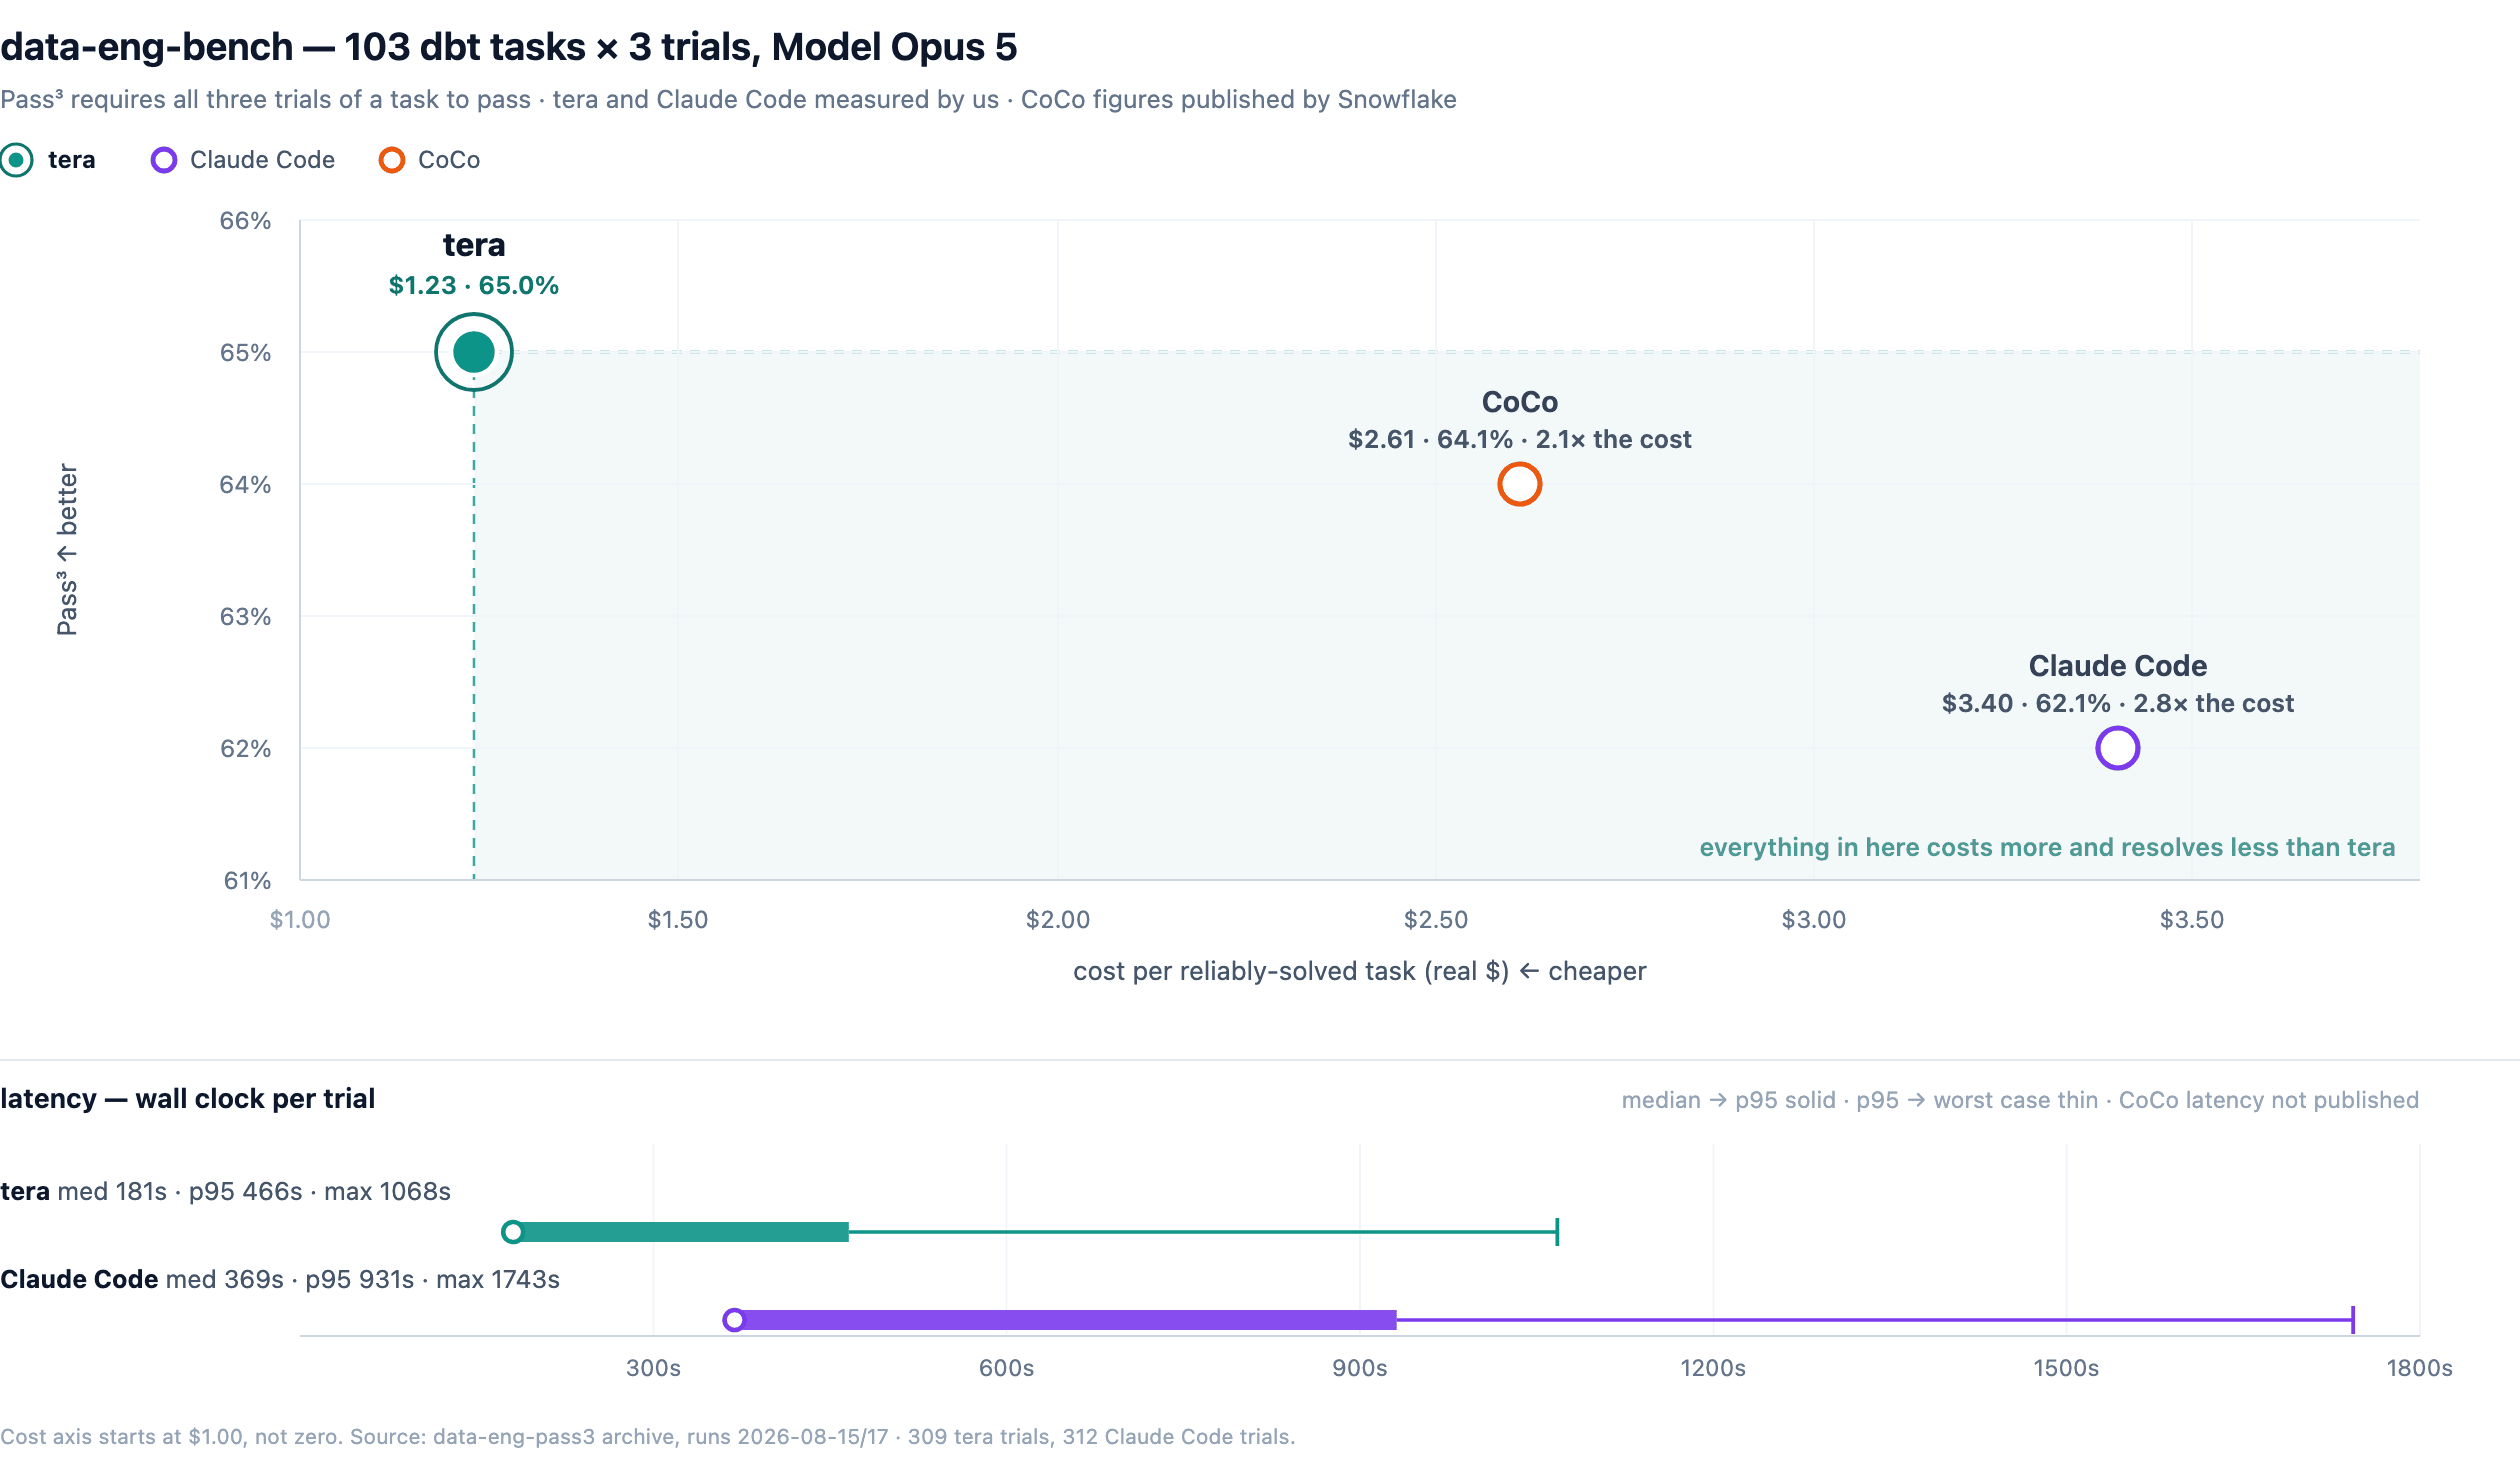
確実に納品されたパイプラインあたりのコスト:Tera:$1.23、CoCo(Snowflake独自エージェント):$2.61、Claude Code:$3.40
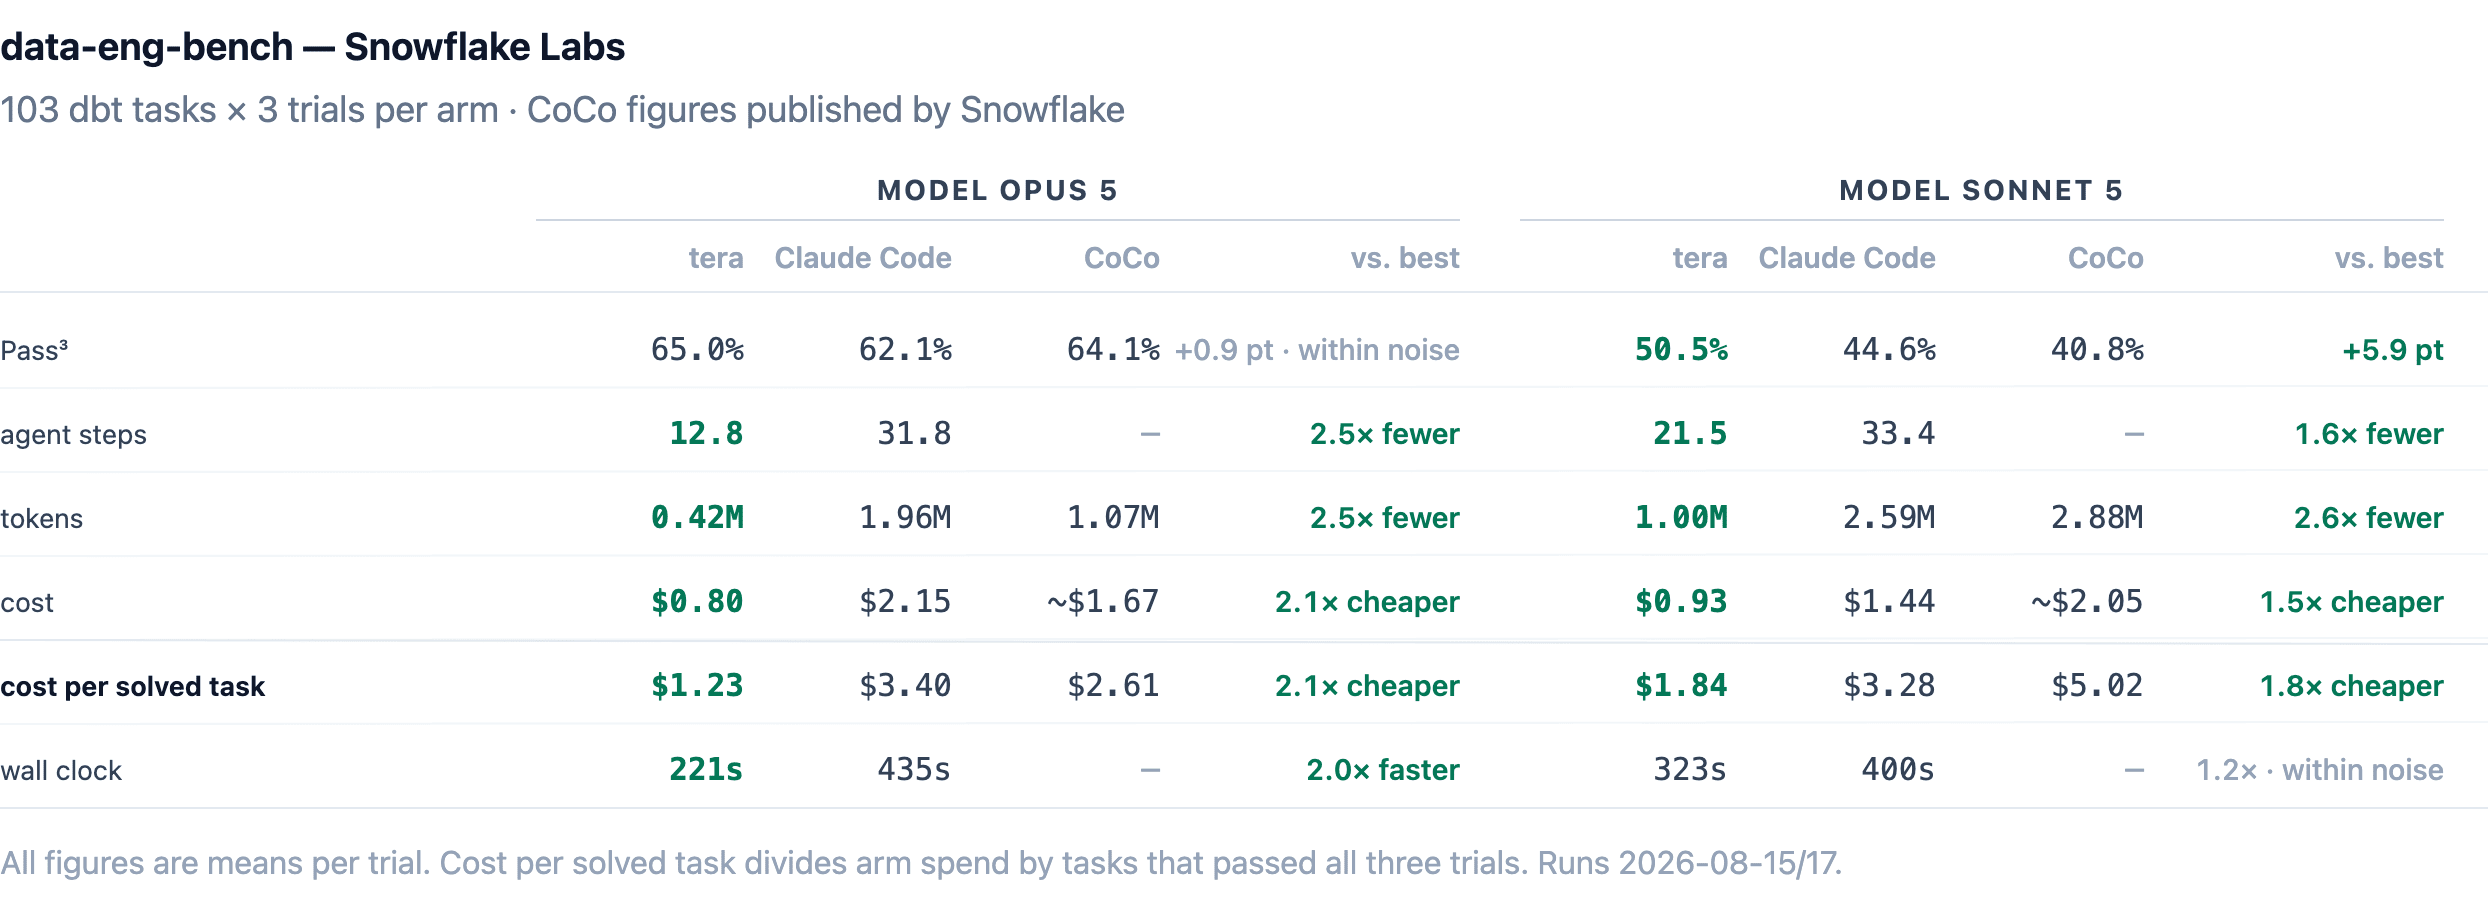
ᵖ CoCoの数値はSnowflake公表値に基づき、完全原価計算で推定。Snowflakeは自社のClaude Code実行に対する倍率のみを公開しているため、ステップ数およびツール操作数は空欄
ADE-bench—dbt Labs
dbt LabsによるADE-benchは、データエンジニアリングからアナリティクスエンジニアリングへと一歩踏み出した領域です。airbnb、asana、quickbooks、formula oneといった実在のdbtプロジェクトにおける75件のタスクで構成されます。「パッケージ更新でコンパイルが壊れた」「指標が誤った数値を返している」「モデルの再構成が必要」といった課題に対し、実際の現場と同様に「変更が何ファイルに及ぶか把握していない担当者からの2文程度の指示文」から開始され、影響範囲を特定する作業自体がタスクに含まれます。
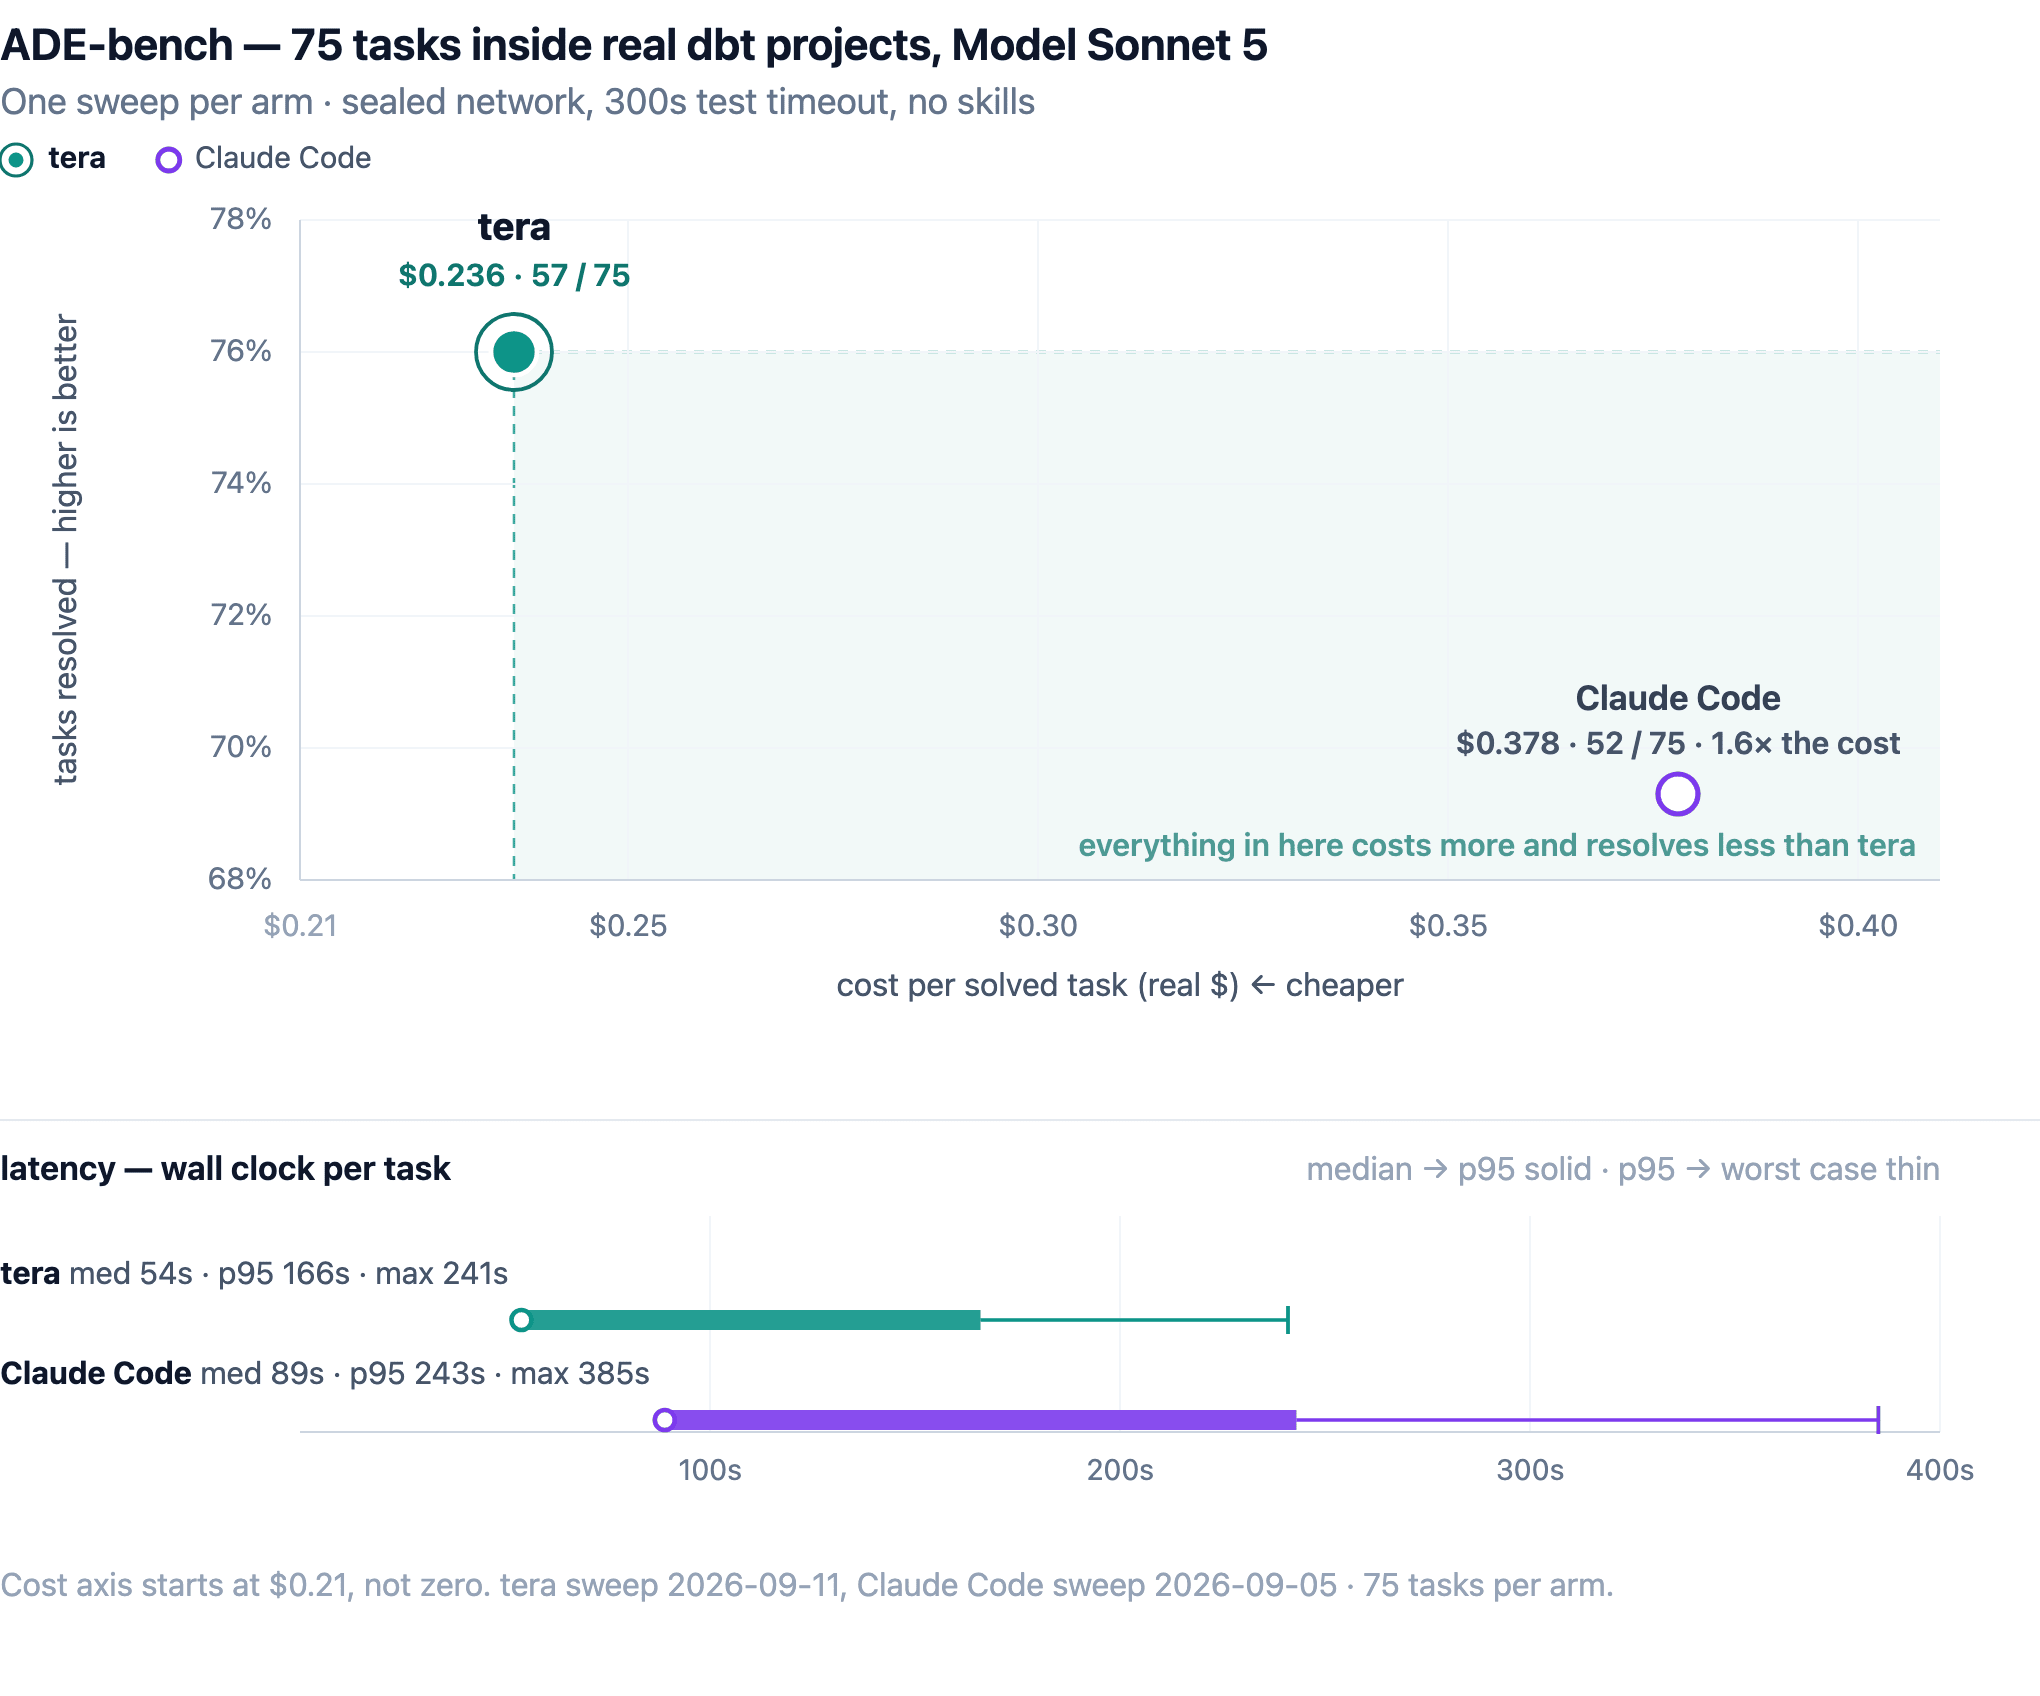
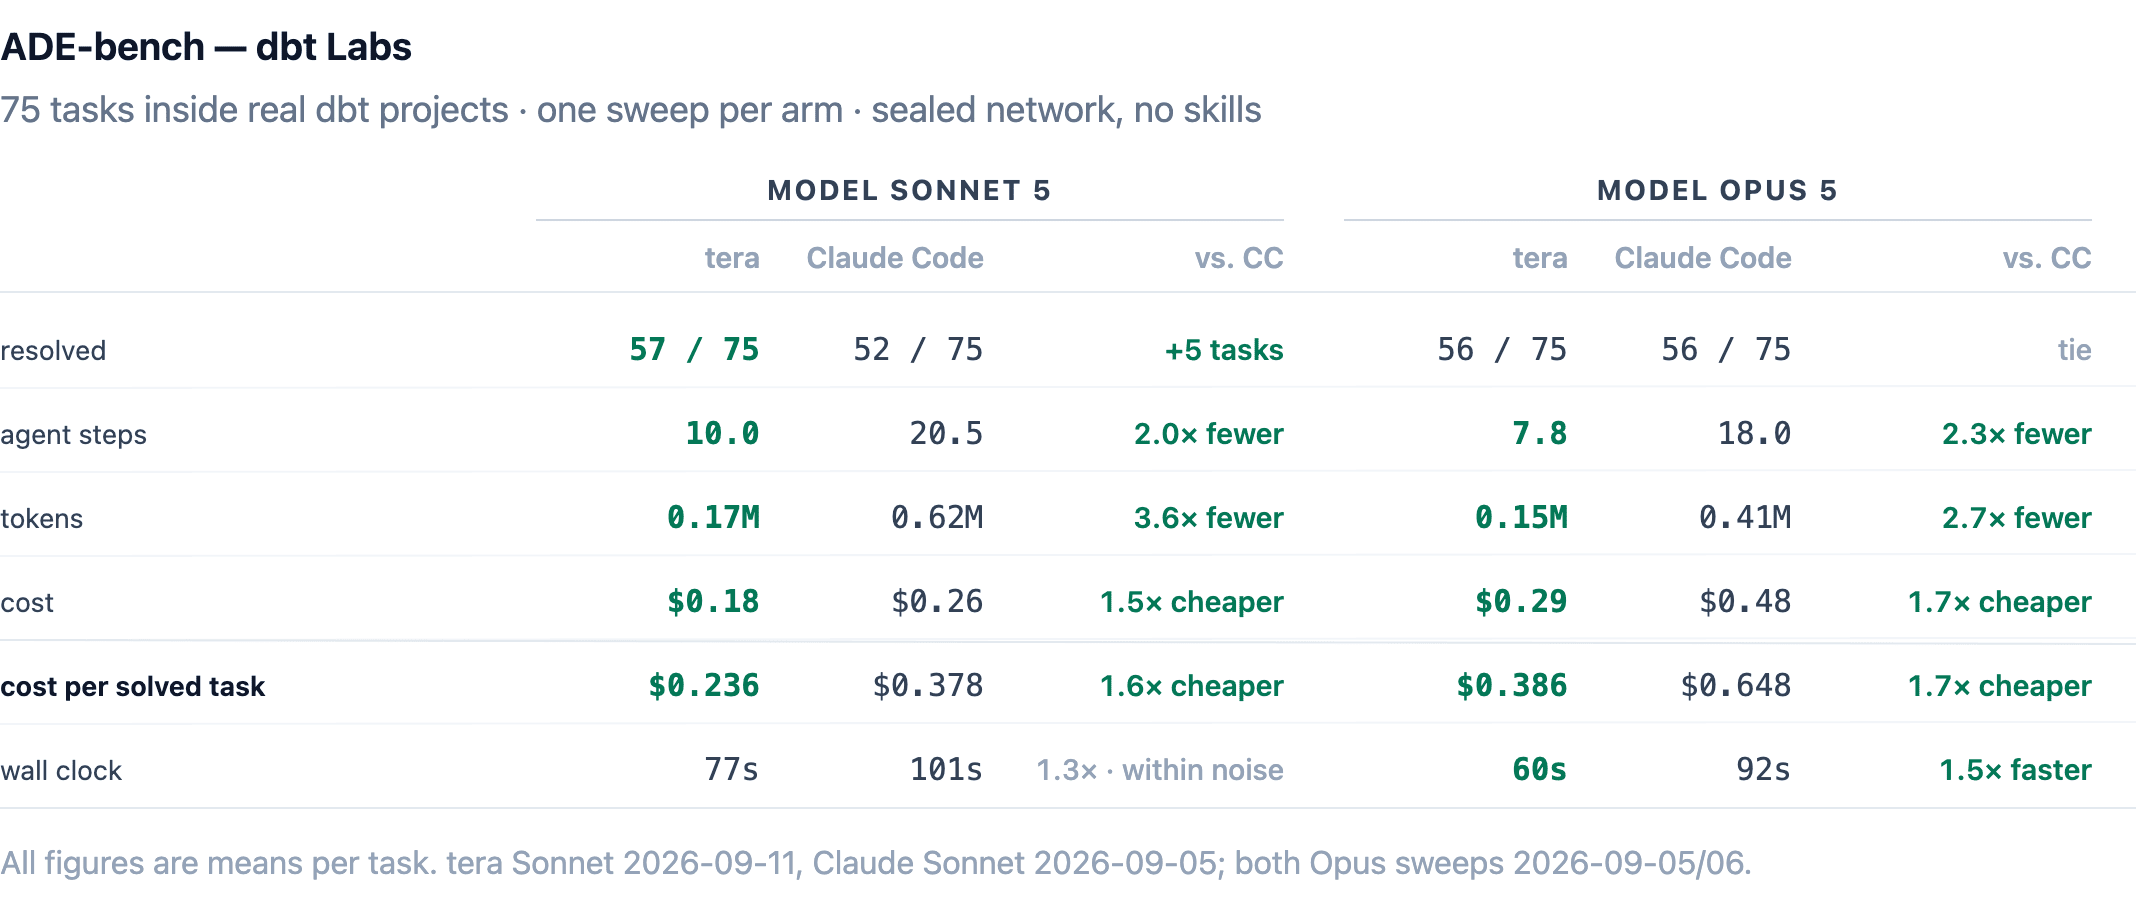
Tera Sonnetは、2026年9月11日の最新3ff09585スウィープ(57/75)です。Claude Sonnetは、2026年9月5日 08:58のシール済みスウィープ(52/75)であり、これはマッチドアームのベースラインとなります。Tera Opusは2026年9月6日 03:21のスイープ(56/75)であり、Claude Opusは2026年9月5日 07:27のスイープ(56/75)です。すべてus-west-2 Bedrock上で、シールドネットワーク、テストタイムアウト300秒の条件下で実行されました。
Teraは、コスト、実測時間、および両方のモデル階層におけるターン数において優れた結果となりました。Sonnetでは、Teraが5つ多くのタスクを解決しました。Opusでは、両エージェントとも56/75で同点でしたが、Teraは実測時間の60%、コストの60%でこれを達成しました。
DataAgentBench—UC Berkeley and Hasura
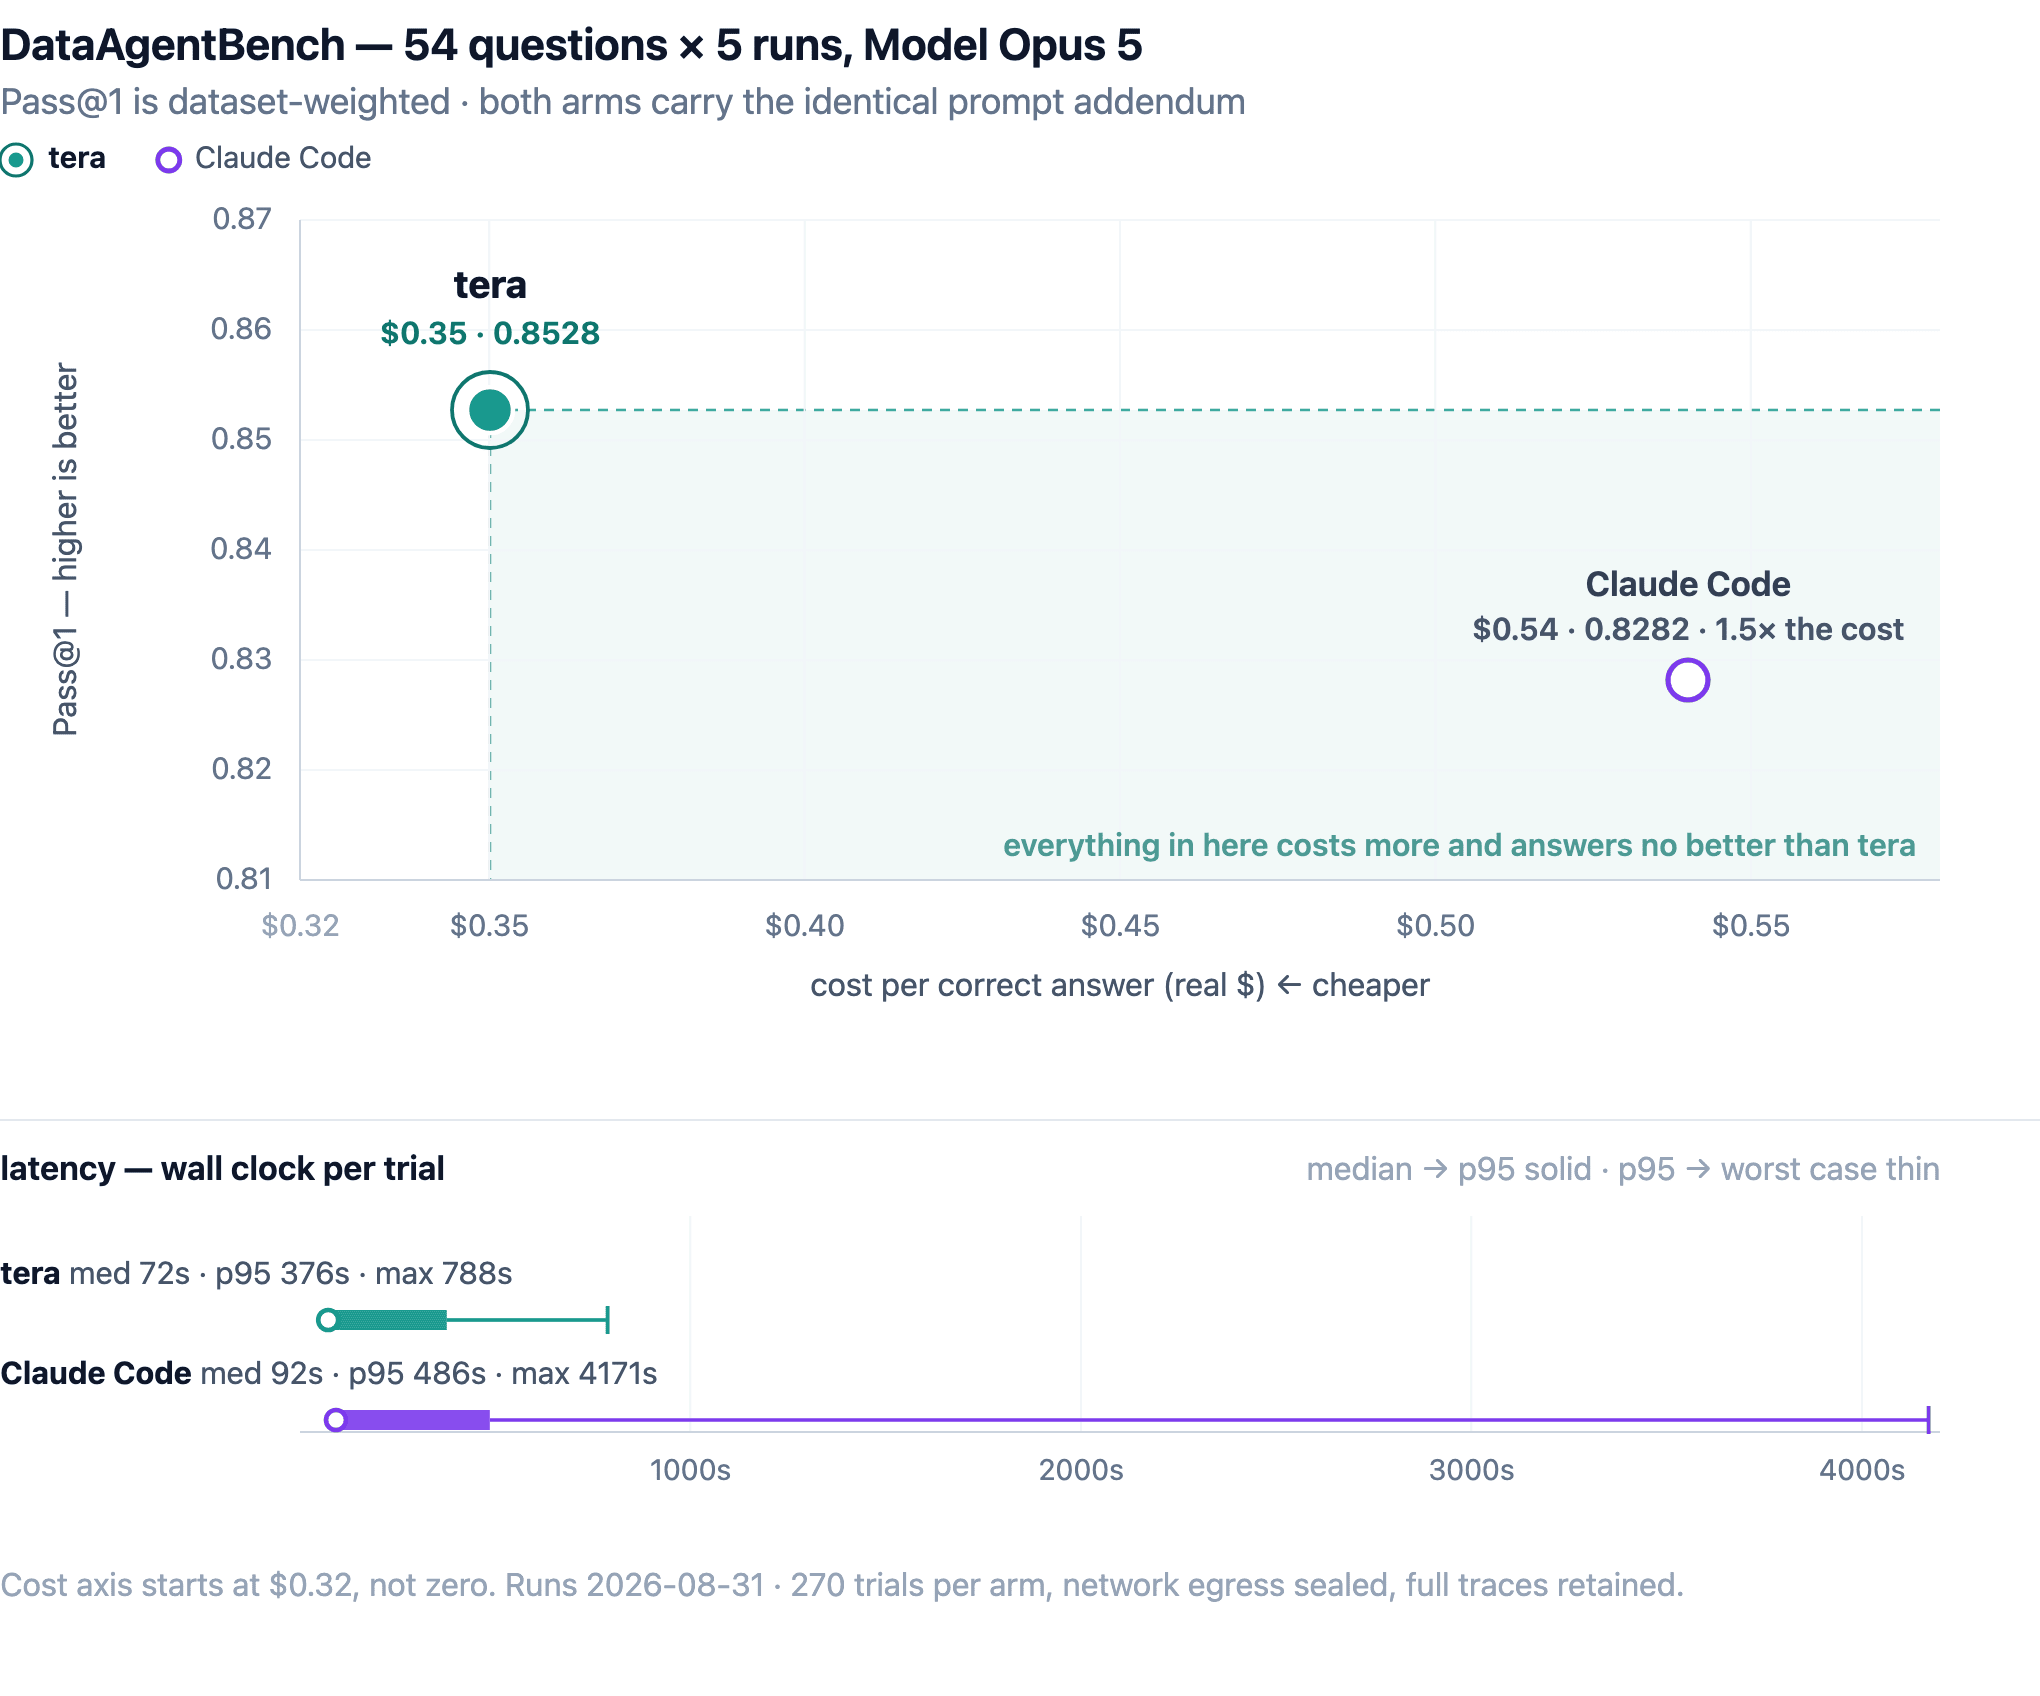
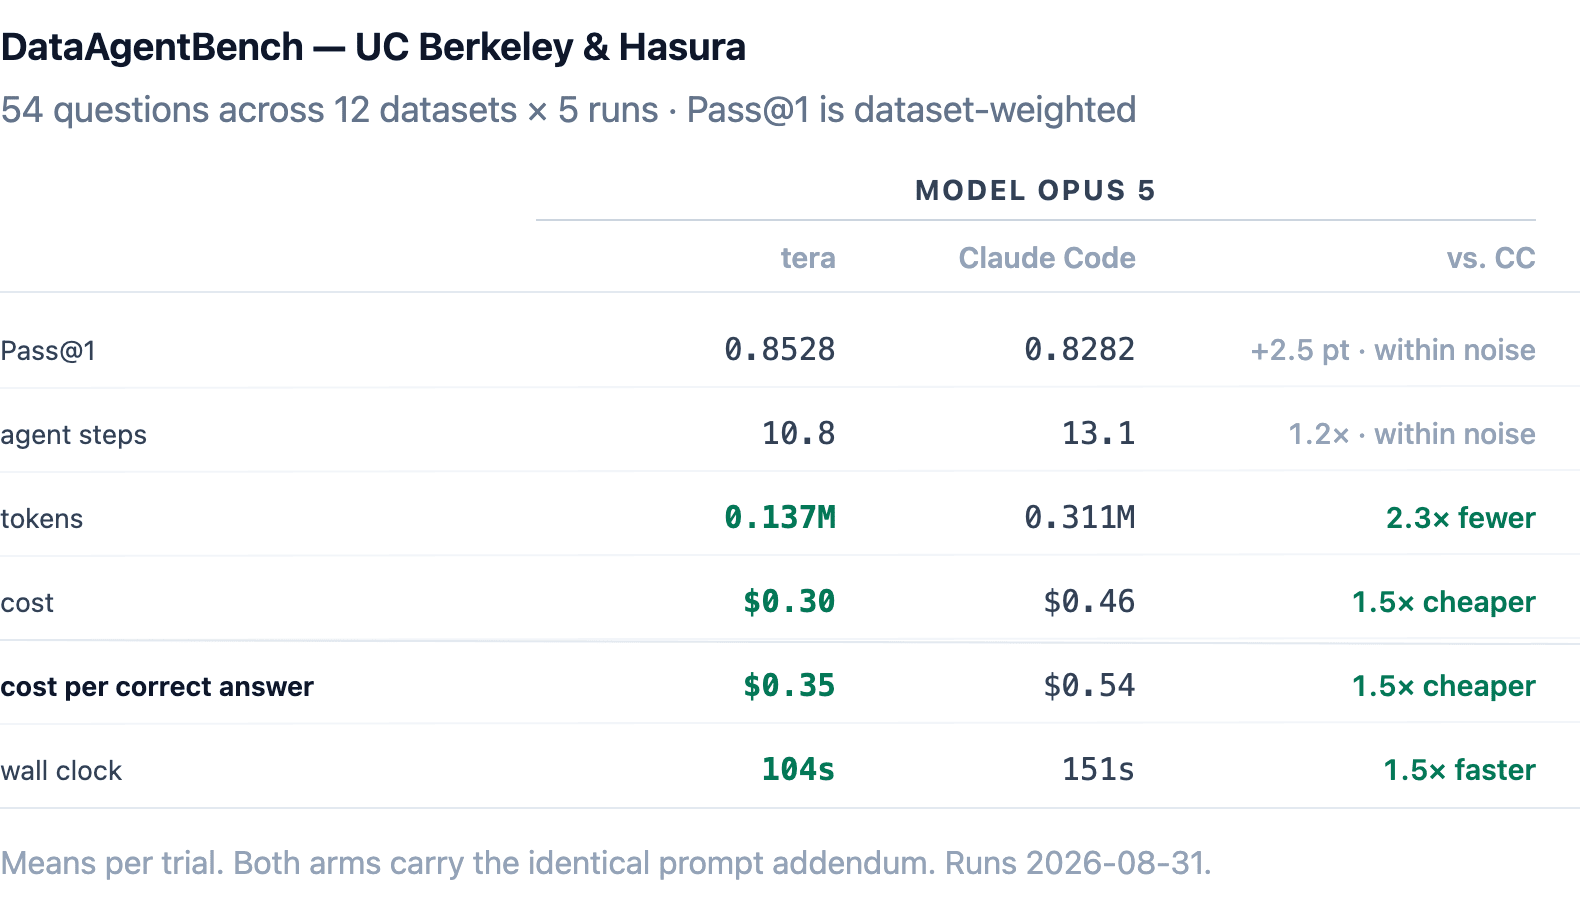
UC BerkeleyとHasuraによるDataAgentBenchは、他とは大きく異なるベンチマークです。Yelpレビュー、GitHubリポジトリ、特許出願、CRMレコード、株式市場など、12の実データセットにまたがる54の分析クエリ(各5回実行)が出題され、正解データ(Ground Truth)との完全一致で採点されます。これは意図的に非SQLベンチマークとして設計されています。データは複数のエンジンの複数データベースに分散し、結合キーも揃っておらず、いくつかのケースでは計算を行う前に非構造化テキストから回答を抽出する必要があります。
SWE-bench Pro—Scale AI
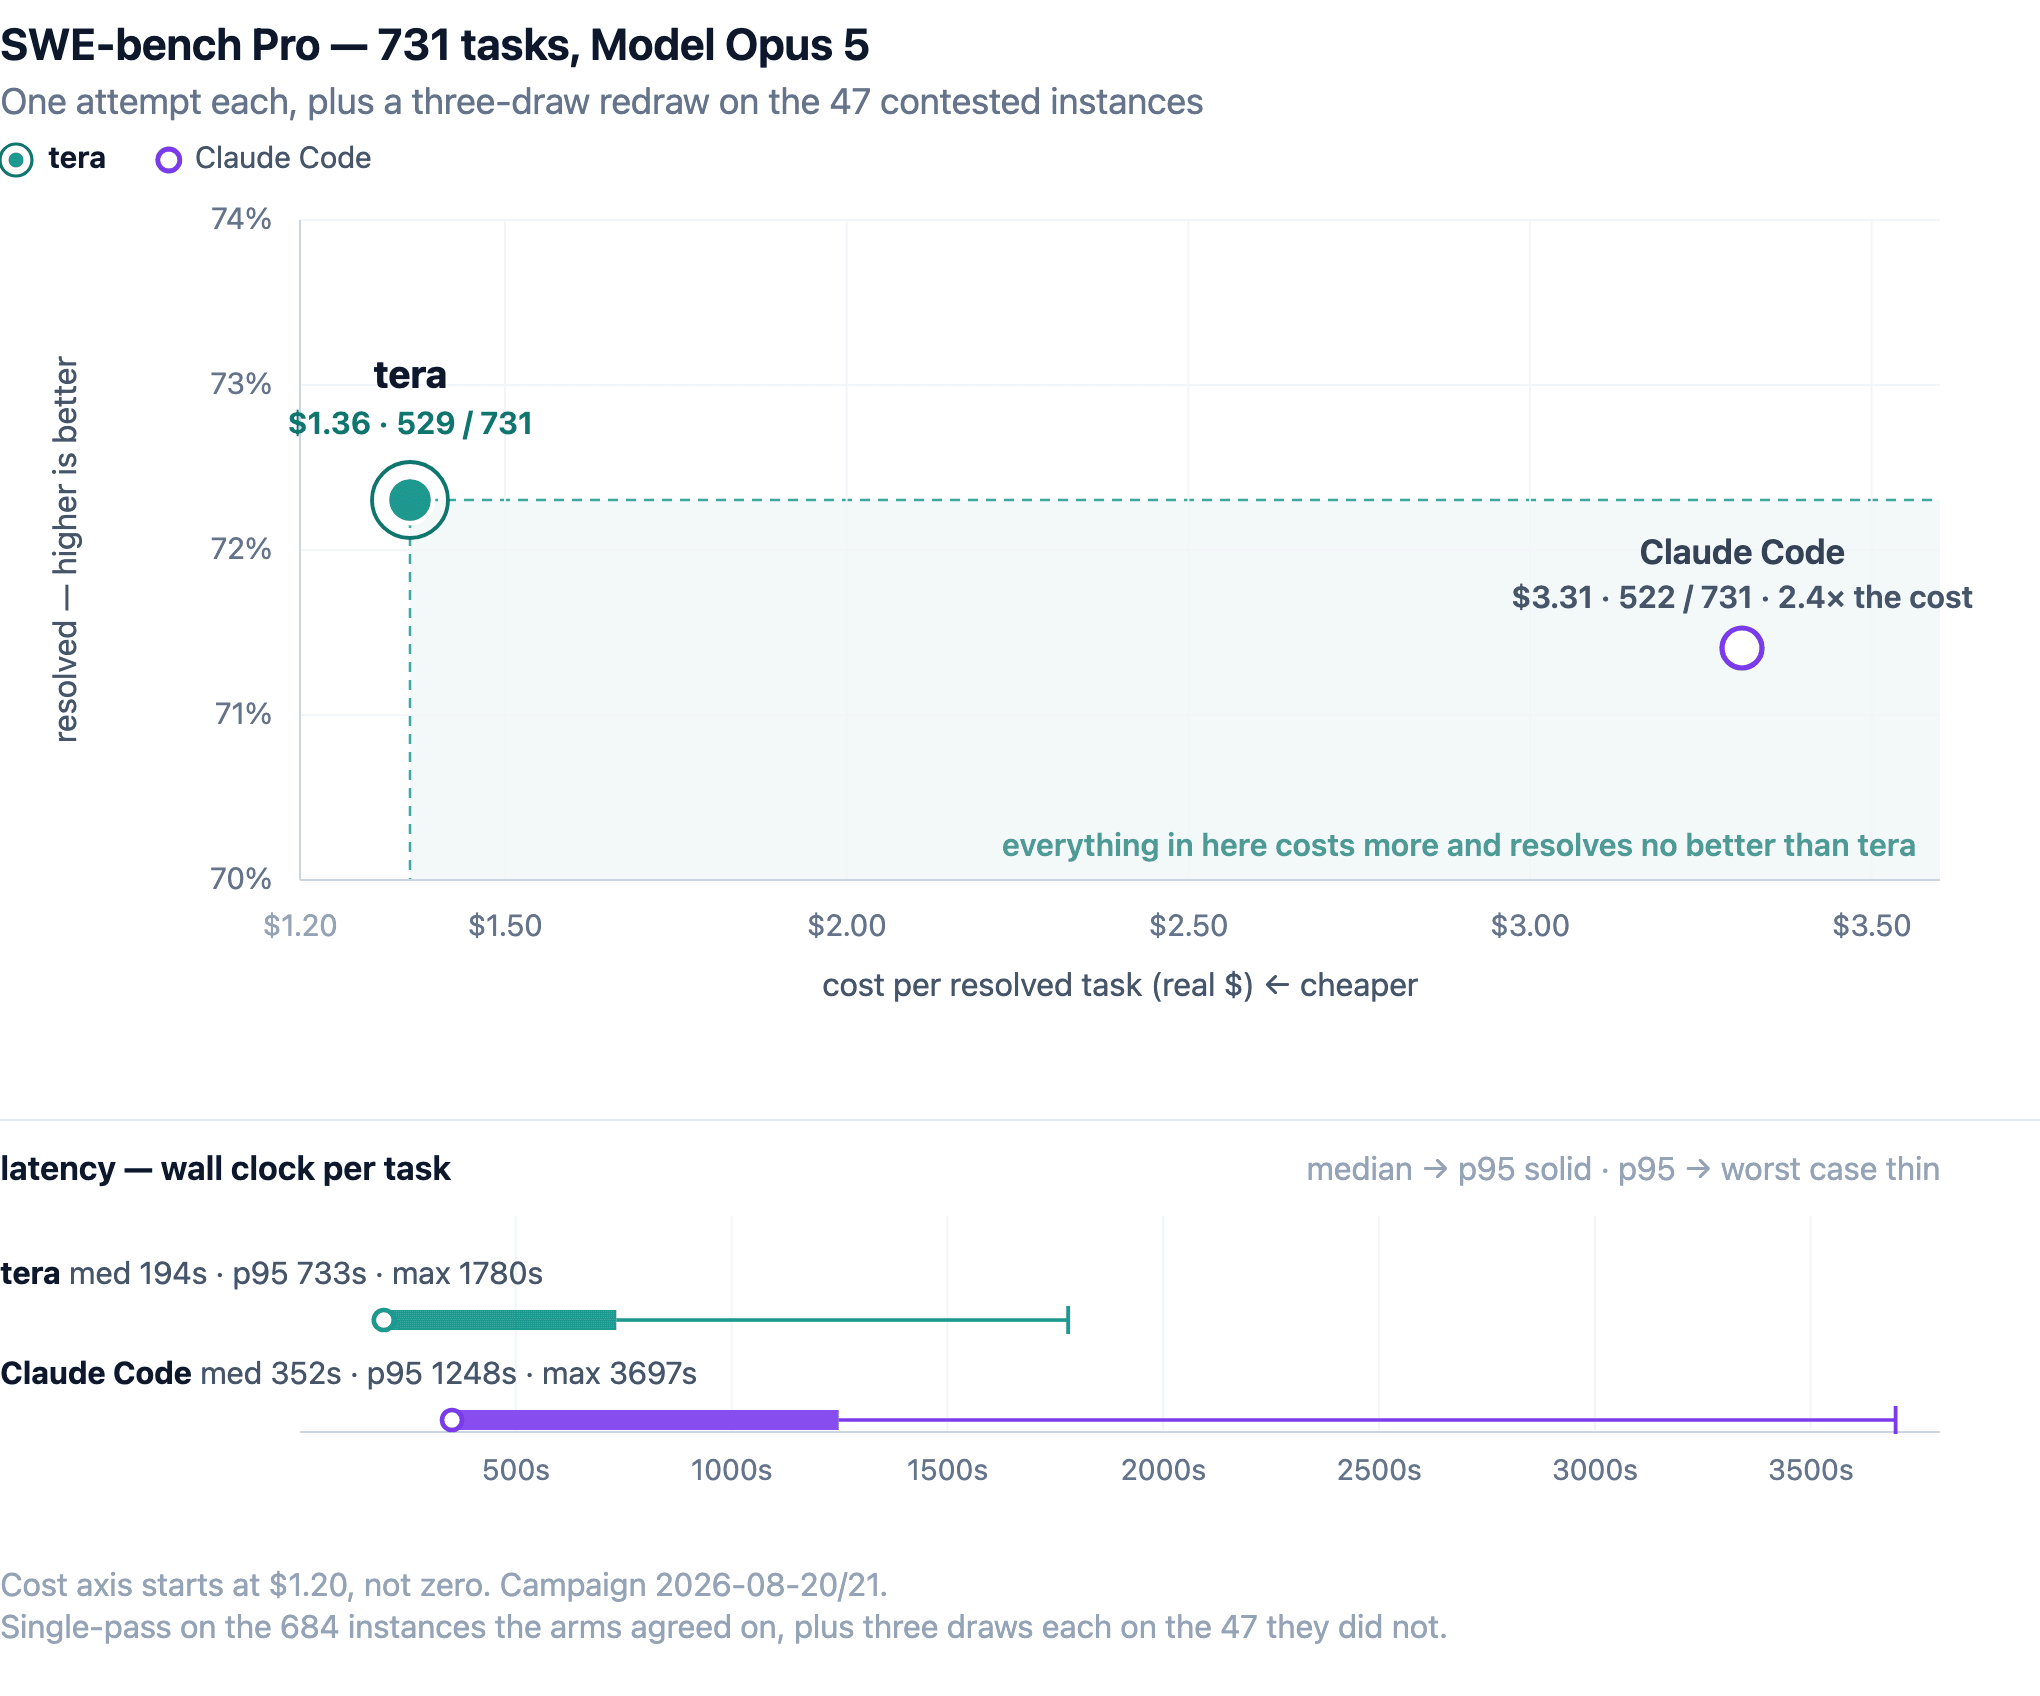
Scale AIによるSWE-bench Proは一般的なソフトウェアエンジニアリングのベンチマークであり、私たちが本来ターゲットとしていなかった領域です。Ansible、Teleport、Proton Mail、qutebrowser、NodeBB、Elementなどの本番オープンソースシステムから実際にマージされた731件のプルリクエストで構成されています。エージェントには修正直前のリポジトリと、ユーザーが実際に投稿したIssueテキストが提供されます。作業完了後、それまで非公開だったメンテナー自身のテストスイートが適用され、失敗していた全テストが通過し、かつ既存のテストがすべて通過し続けた場合のみ解決と判定されます。部分点やモデルによる判定は一切ありません。
データ領域で培った規律が一般化できるかを検証するため、最も厳しい試練としてこのテストを実施しました。両エージェントとも同一制限下でclaude-opus-5を駆動させたため、モデルの基礎能力は開始前に固定されています。ハーネスがモデルの能力自体を引き上げることはできません。既存の能力を発揮するためにどれだけのコンピュートを費やすかを決定するだけです。
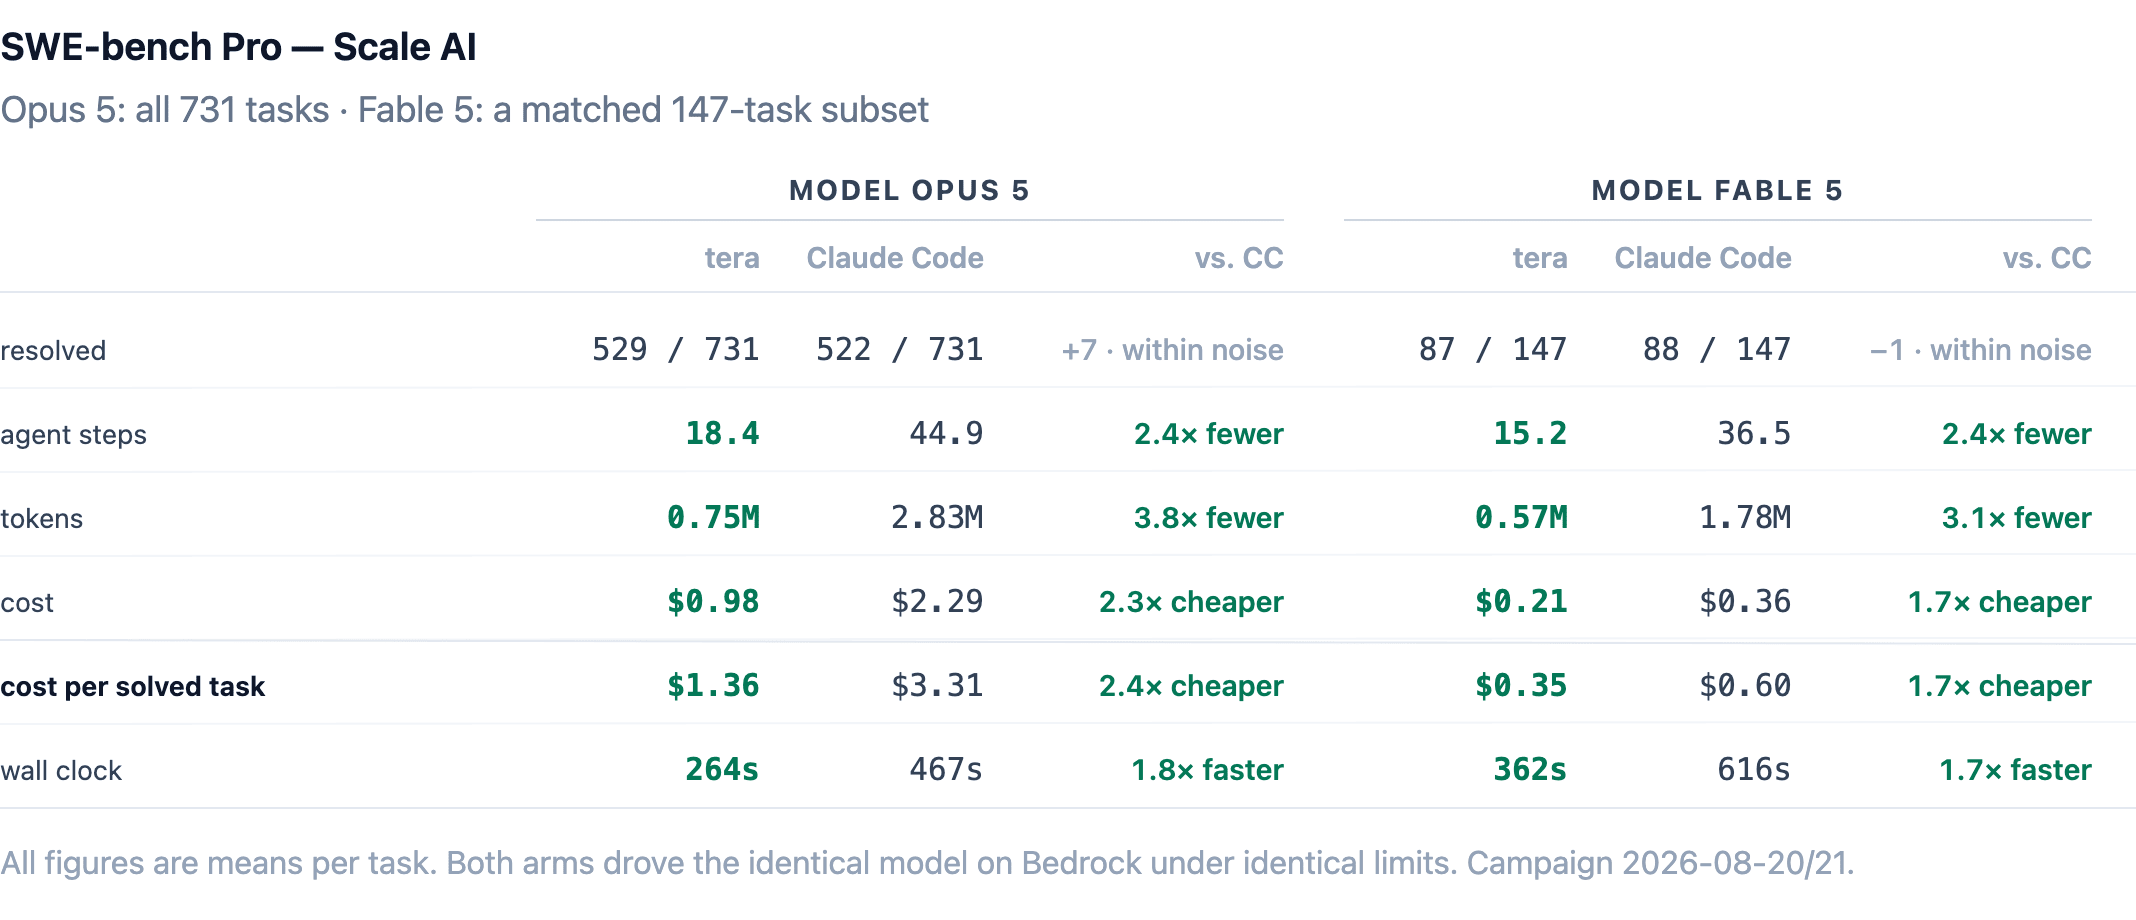
Opus arm:731タスクの全キャンペーン / Fable arm:147インスタンスのサブセット
エージェントのターン数―最重要変数(The Master Variable)
すべてのエージェントの利用コストにおいて、決定的な支配項となるのが「タスク完了までに要するターン数」です。ターンが発生するたびに対話履歴全体が再読み込みされ、新たな推論トークンが消費されます。請求金額はターン数のみによって決まります。
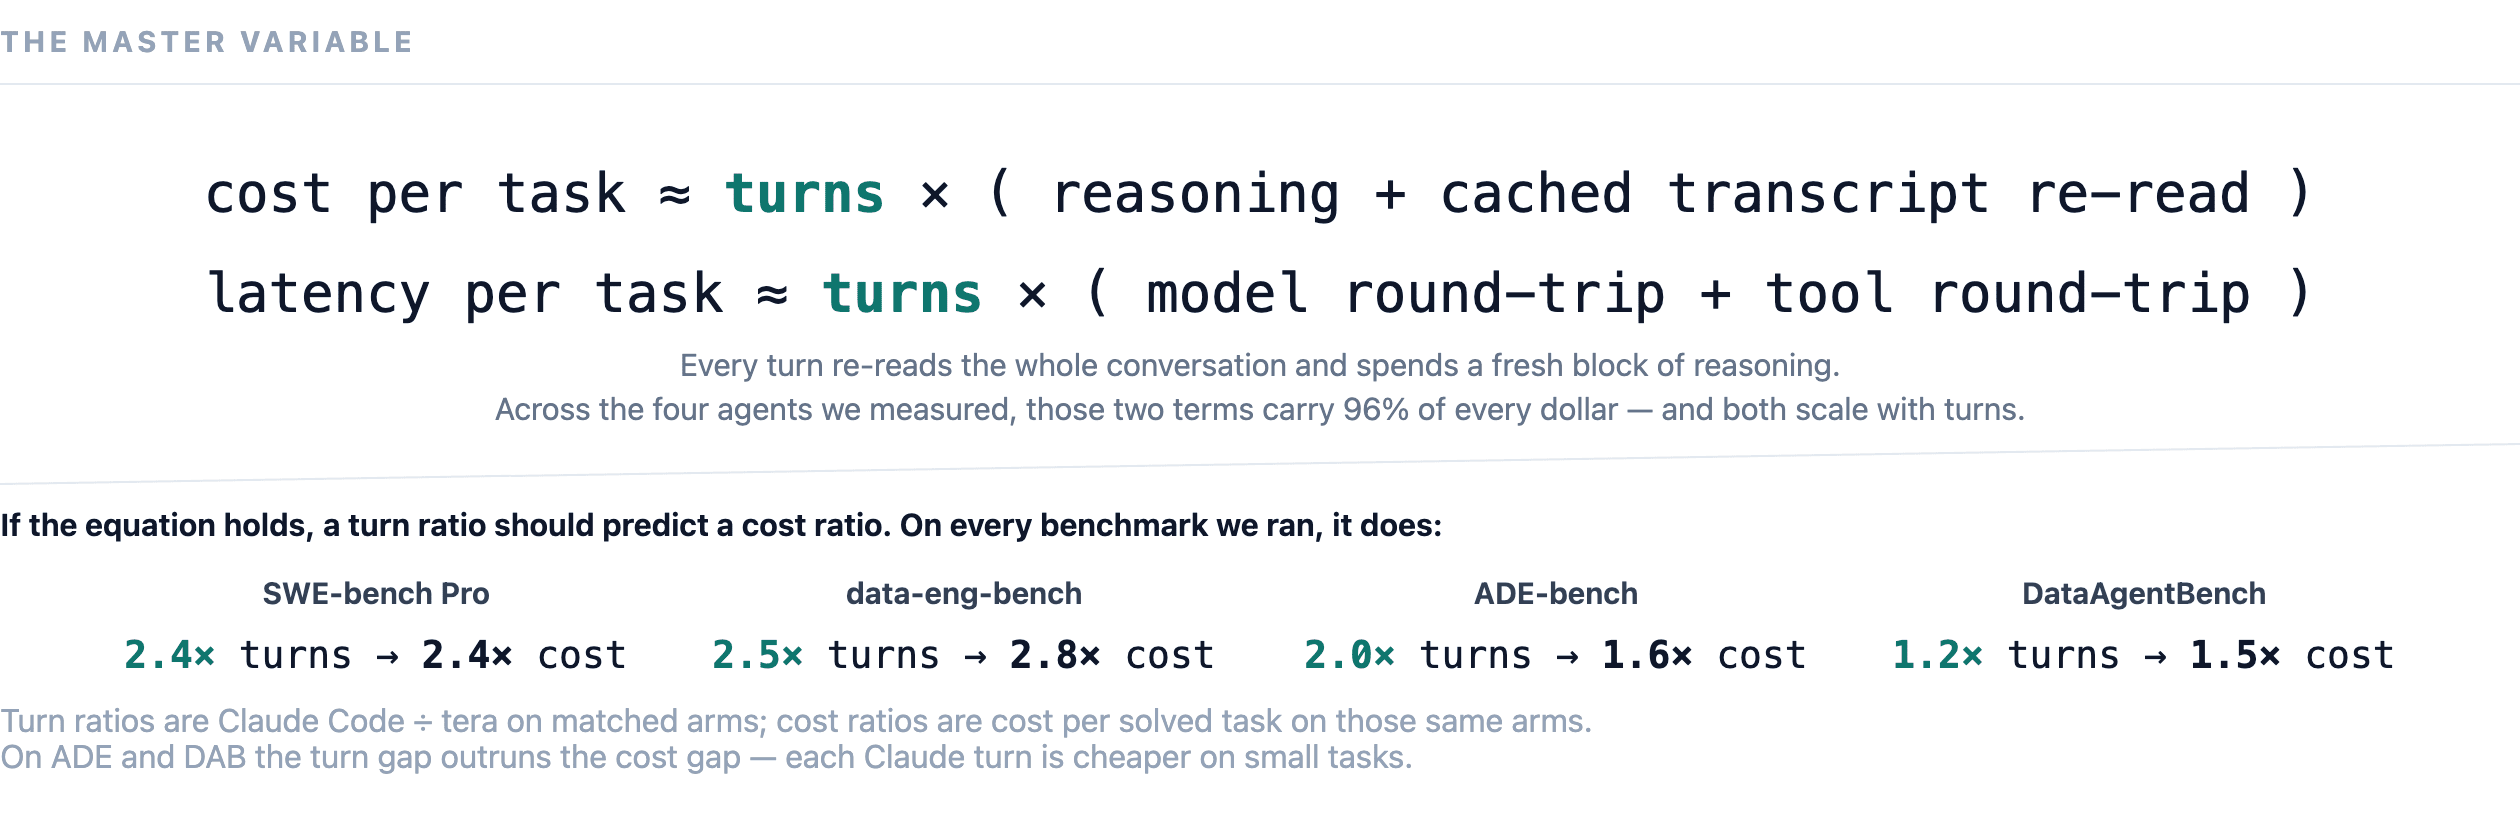
これはTera固有の主張ではありません。チャット完了APIの課金構造そのものの特性です。測定した4つのエージェント全体において、キャッシュの再読み込みと推論が総費用の96%を占めており、双方がターン数に比例してスケールします。ターン数を削減できれば、費用の両要素が同時に激減します。ターン数を削減できれば、所要時間も短縮されます。ターン数を削減できれば、誤ったステップを踏む確率も低減します。
ディープバッチング(Deep Batching)
どのエージェントも何らかのバッチ処理を行っています(Claude Codeは並列ツール呼び出しをバッチ化し、Cursorはファイル読み込みをバッチ化します)。しかしTeraは、バッチ処理を別次元へと引き上げています。データベース、ファイル、シェル、探索、出力のすべてのレイヤーでバッチ処理を実行します。一時的な最適化ではなく、デフォルトの標準動作として「あらゆる場所で、常にバッチ処理を行う」という徹底した設計方針、これこそが私たちが「ディープバッチング(Deep batching)」と呼ぶものです。
バッチ処理を1回行うごとに、1ターンが削減されます。この削減効果は複利で効いてきます:ターン数の削減 → 対話ログの縮小 → 次のターンでの再読み込み量の低減 → さらなるコスト削減
ターン数を半減させることがもたらす真の価値
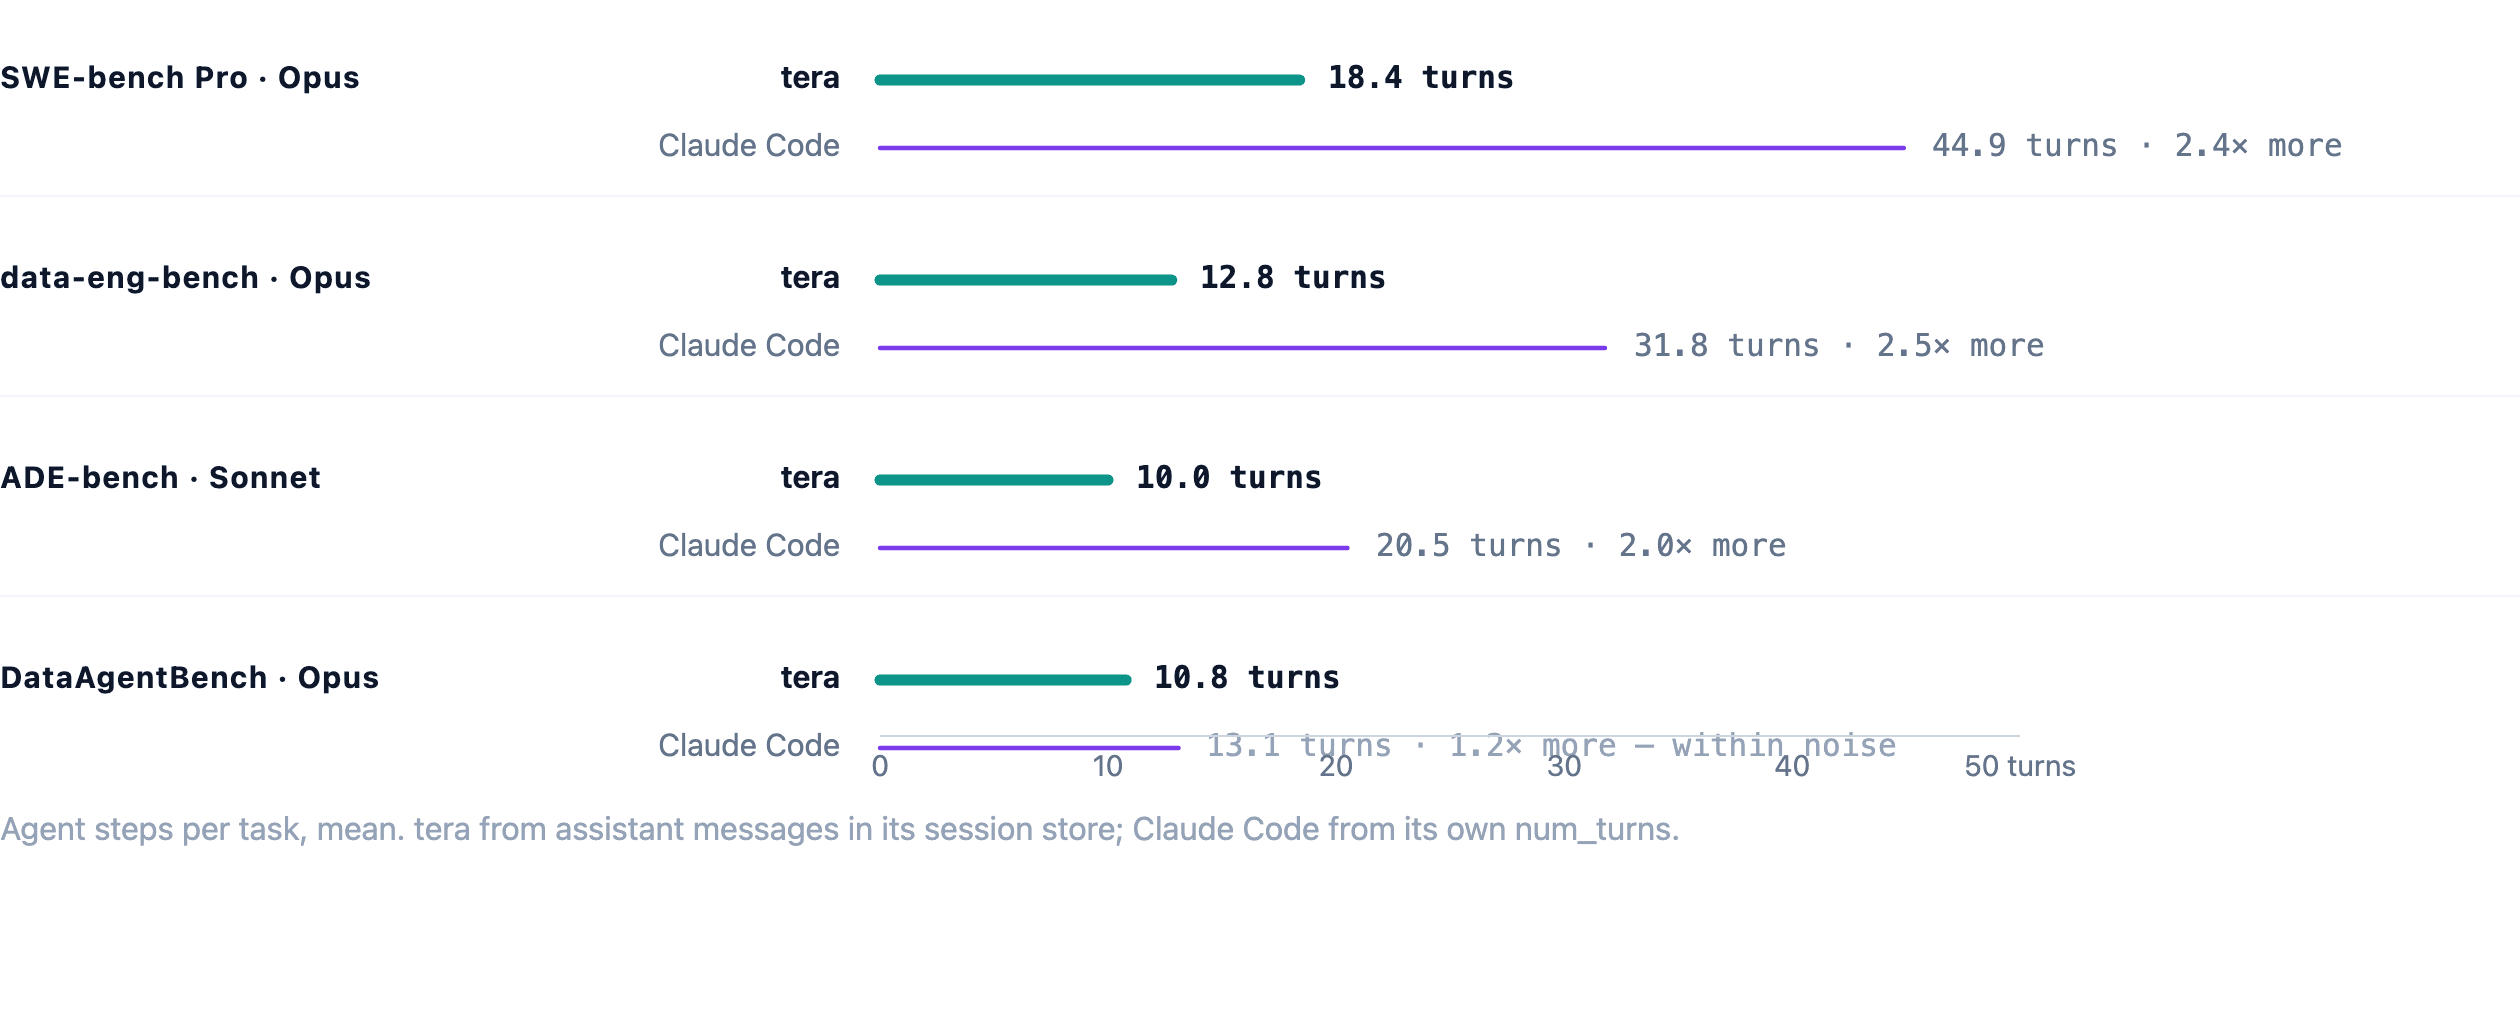
ターン数が減ることで、消費トークン数が減り、費用が減り、所要時間が短縮されます。
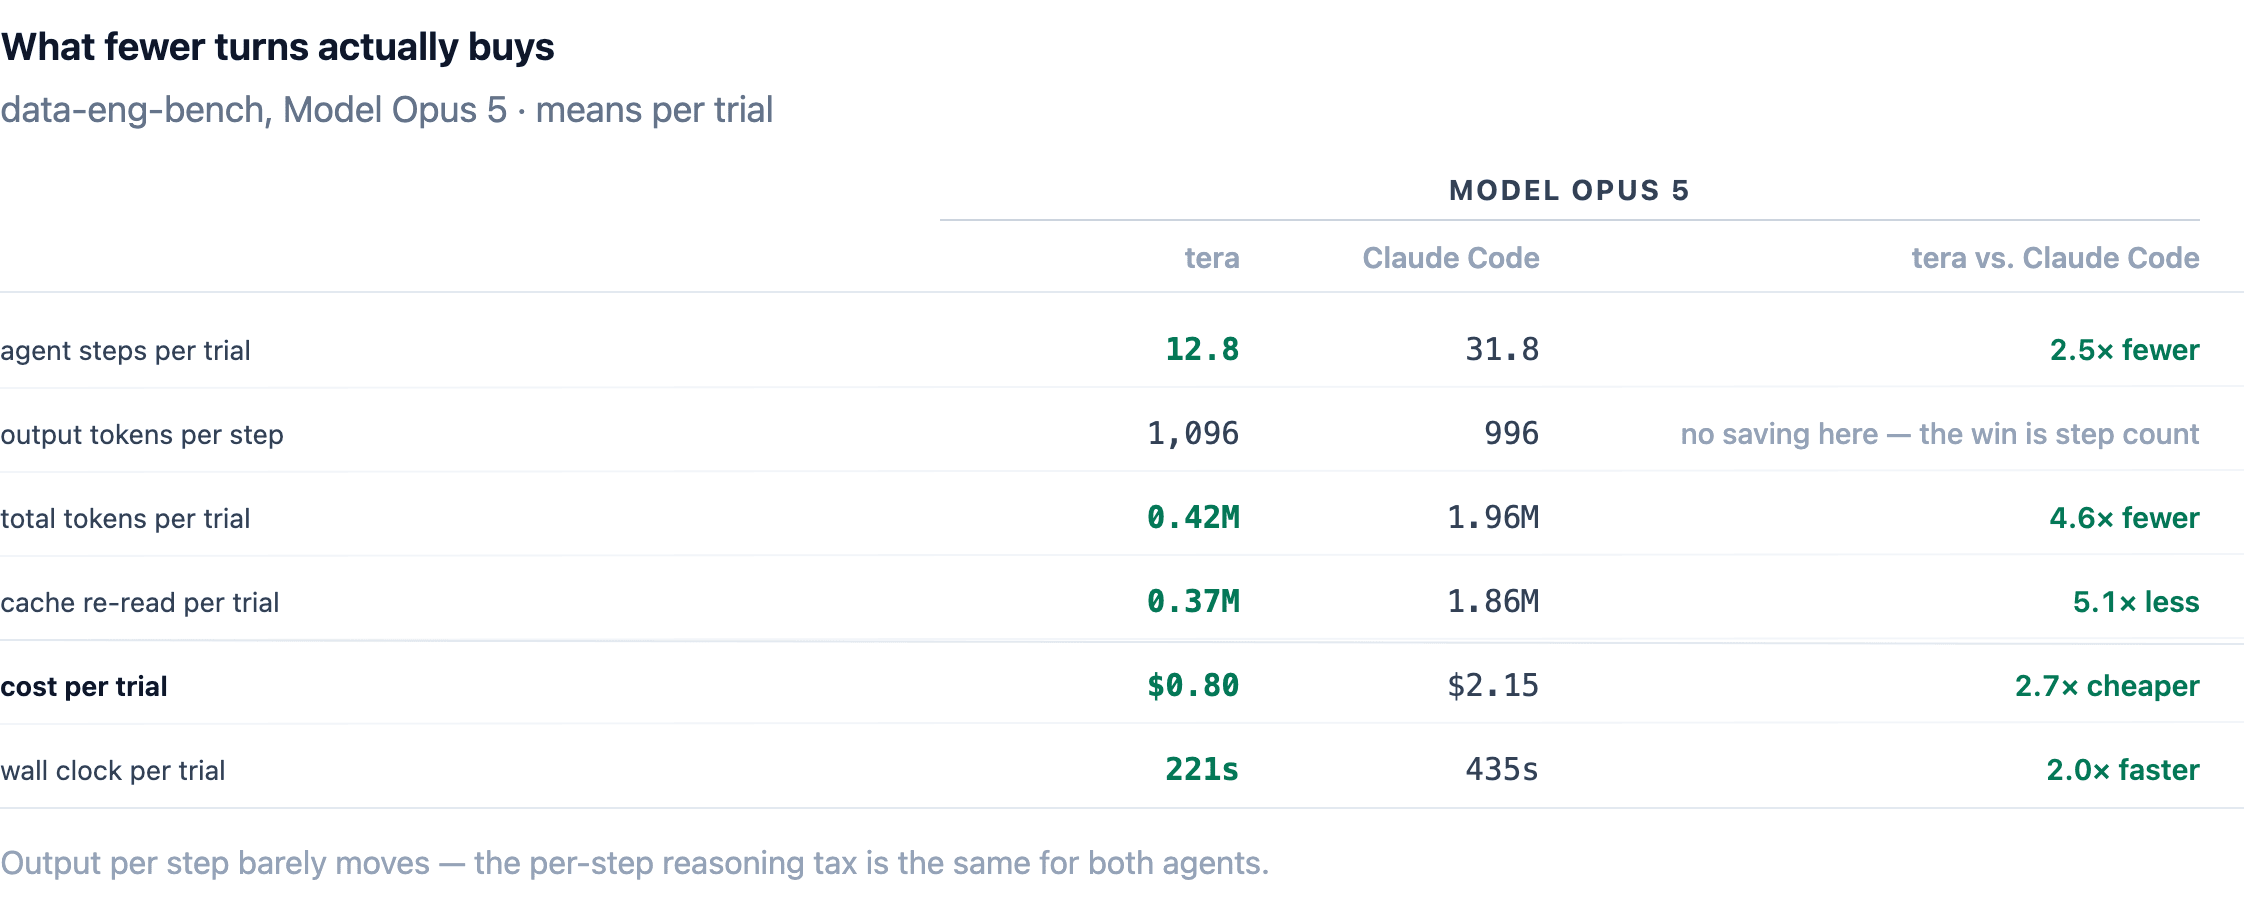
data-eng-benchのOpus実行において、この相乗効果は極めて直接的に現れています:ステップ数 2.5倍削減 → 消費トークン数 4.6倍削減 → コスト 2.7倍削減 → 速度 2.0倍高速化
ターン数削減の内訳:DB、ファイル、シェル
data-eng-bench Opusにおける2.5倍のターン数優位性は、均等に生じているわけではありません。ツール呼び出しを「DB操作」「ファイル操作」「シェル操作」の3系統に分類すると、その内訳が明確になります。TeraはDB操作で約2.3倍、ファイル操作で2.5倍、シェル操作で4.6倍先行しています。
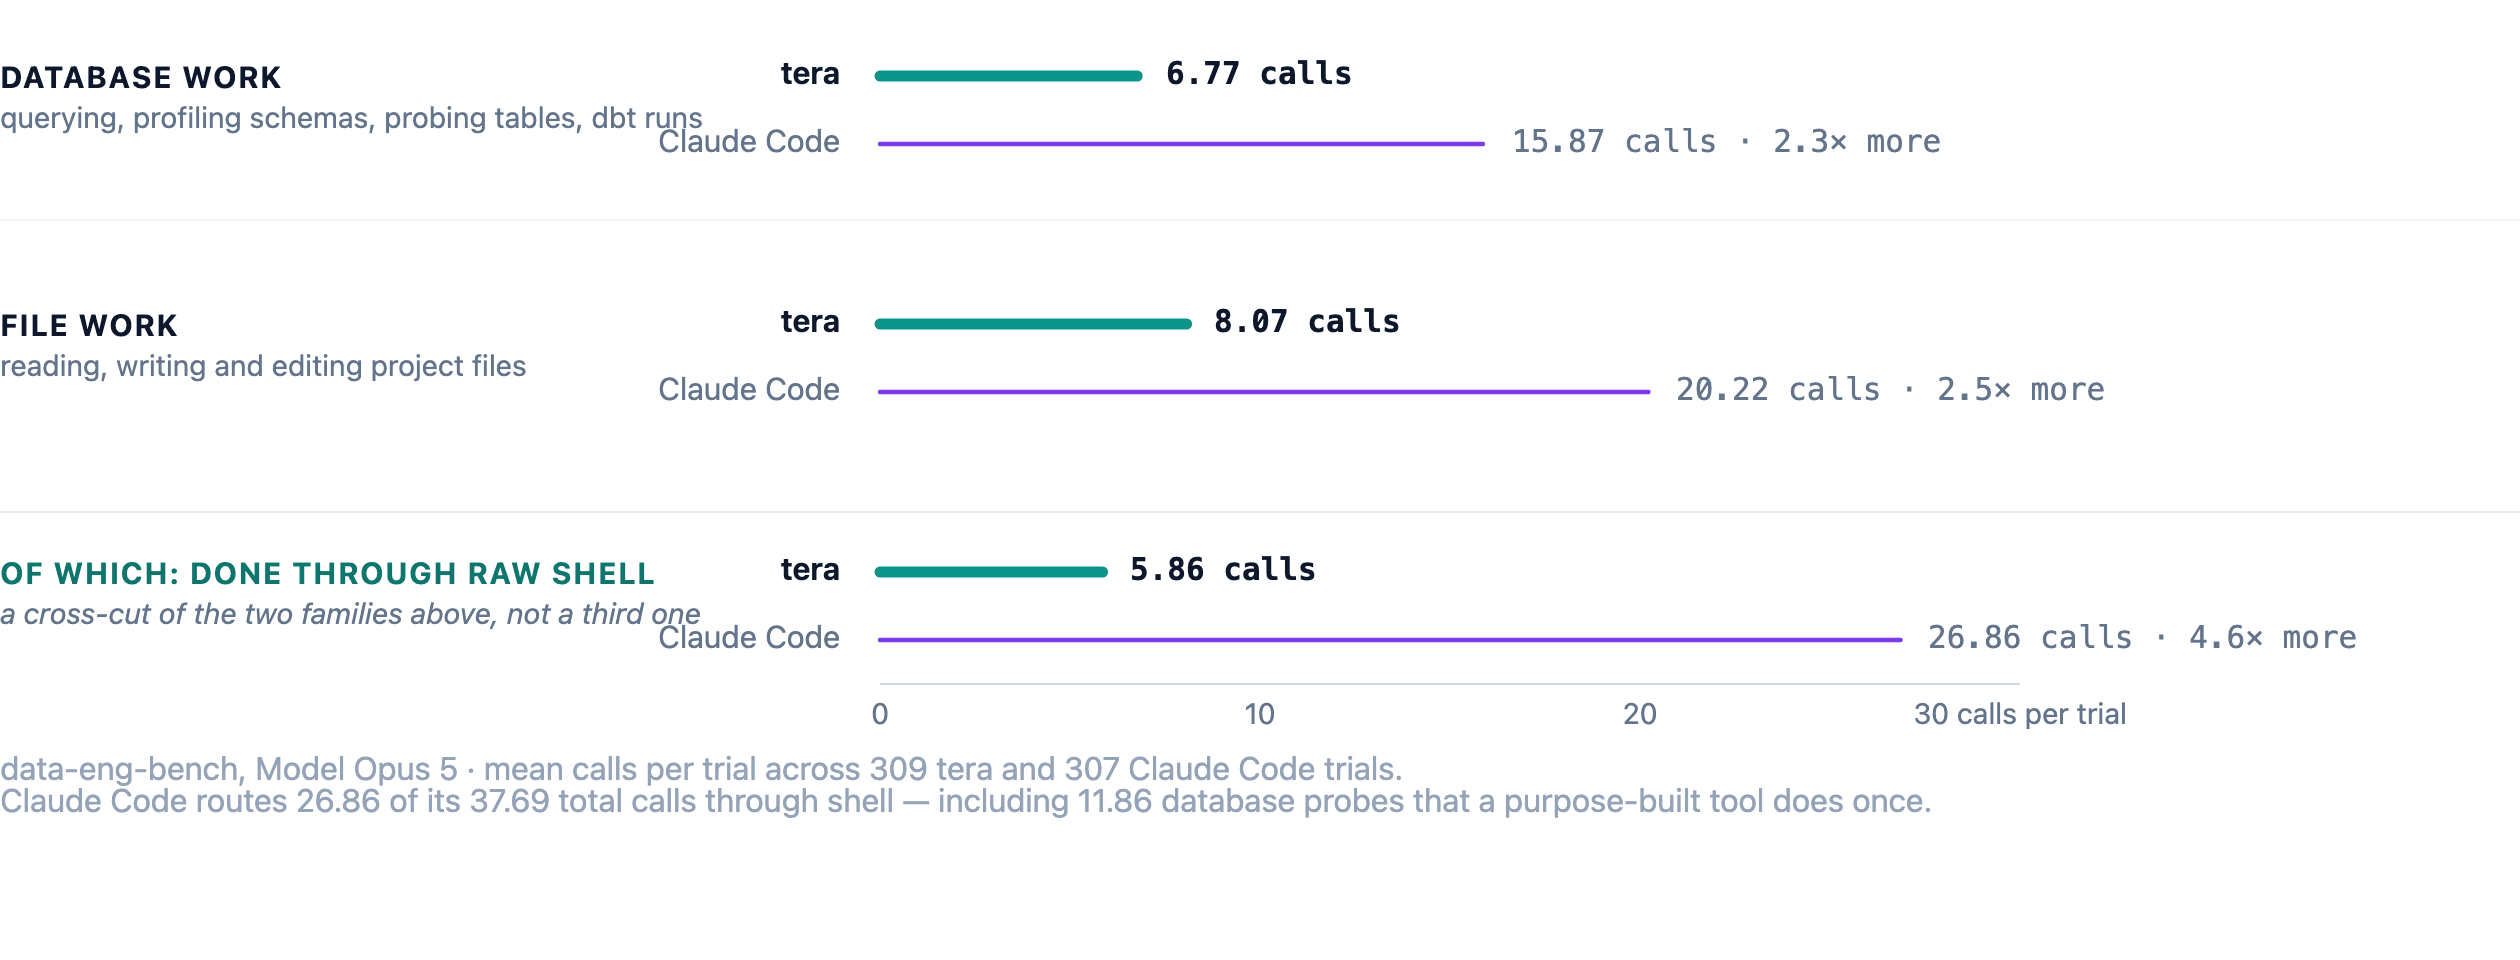
この結果の背景には2つのメカニズムが存在し、データからも明確に裏付けられています:
- 目的特化型ツールによるシェルスクリプトの代替:Claude Codeが持つのは汎用のBashとEditです。対してTeraは、execute_query、table_profile、file_read、file_write、edit_filesを備えています。Claude Codeはシェル経由でデータベース作業を再現しようとするため、テーブル調査(shell_dbprobe)を1試行あたり平均11.86回実行しますが、Teraはわずか0.37回です。このシェル調査の差分1回1回が、Teraがスキップしたターンとなります。
- Teraのツールは1回の呼び出しで複数項目を処理:table_profileは1回の呼び出しで平均3.28テーブルを処理します。Teraは1ターンで調査対象テーブル群全体をプロファイリングします。execute_queryは1回あたり平均1.22のSQL文を実行します。これに対し、シェルを経由するClaude Codeは1回の呼び出しで1項目しか取得できません。
ツール呼び出しプロファイルの全体像
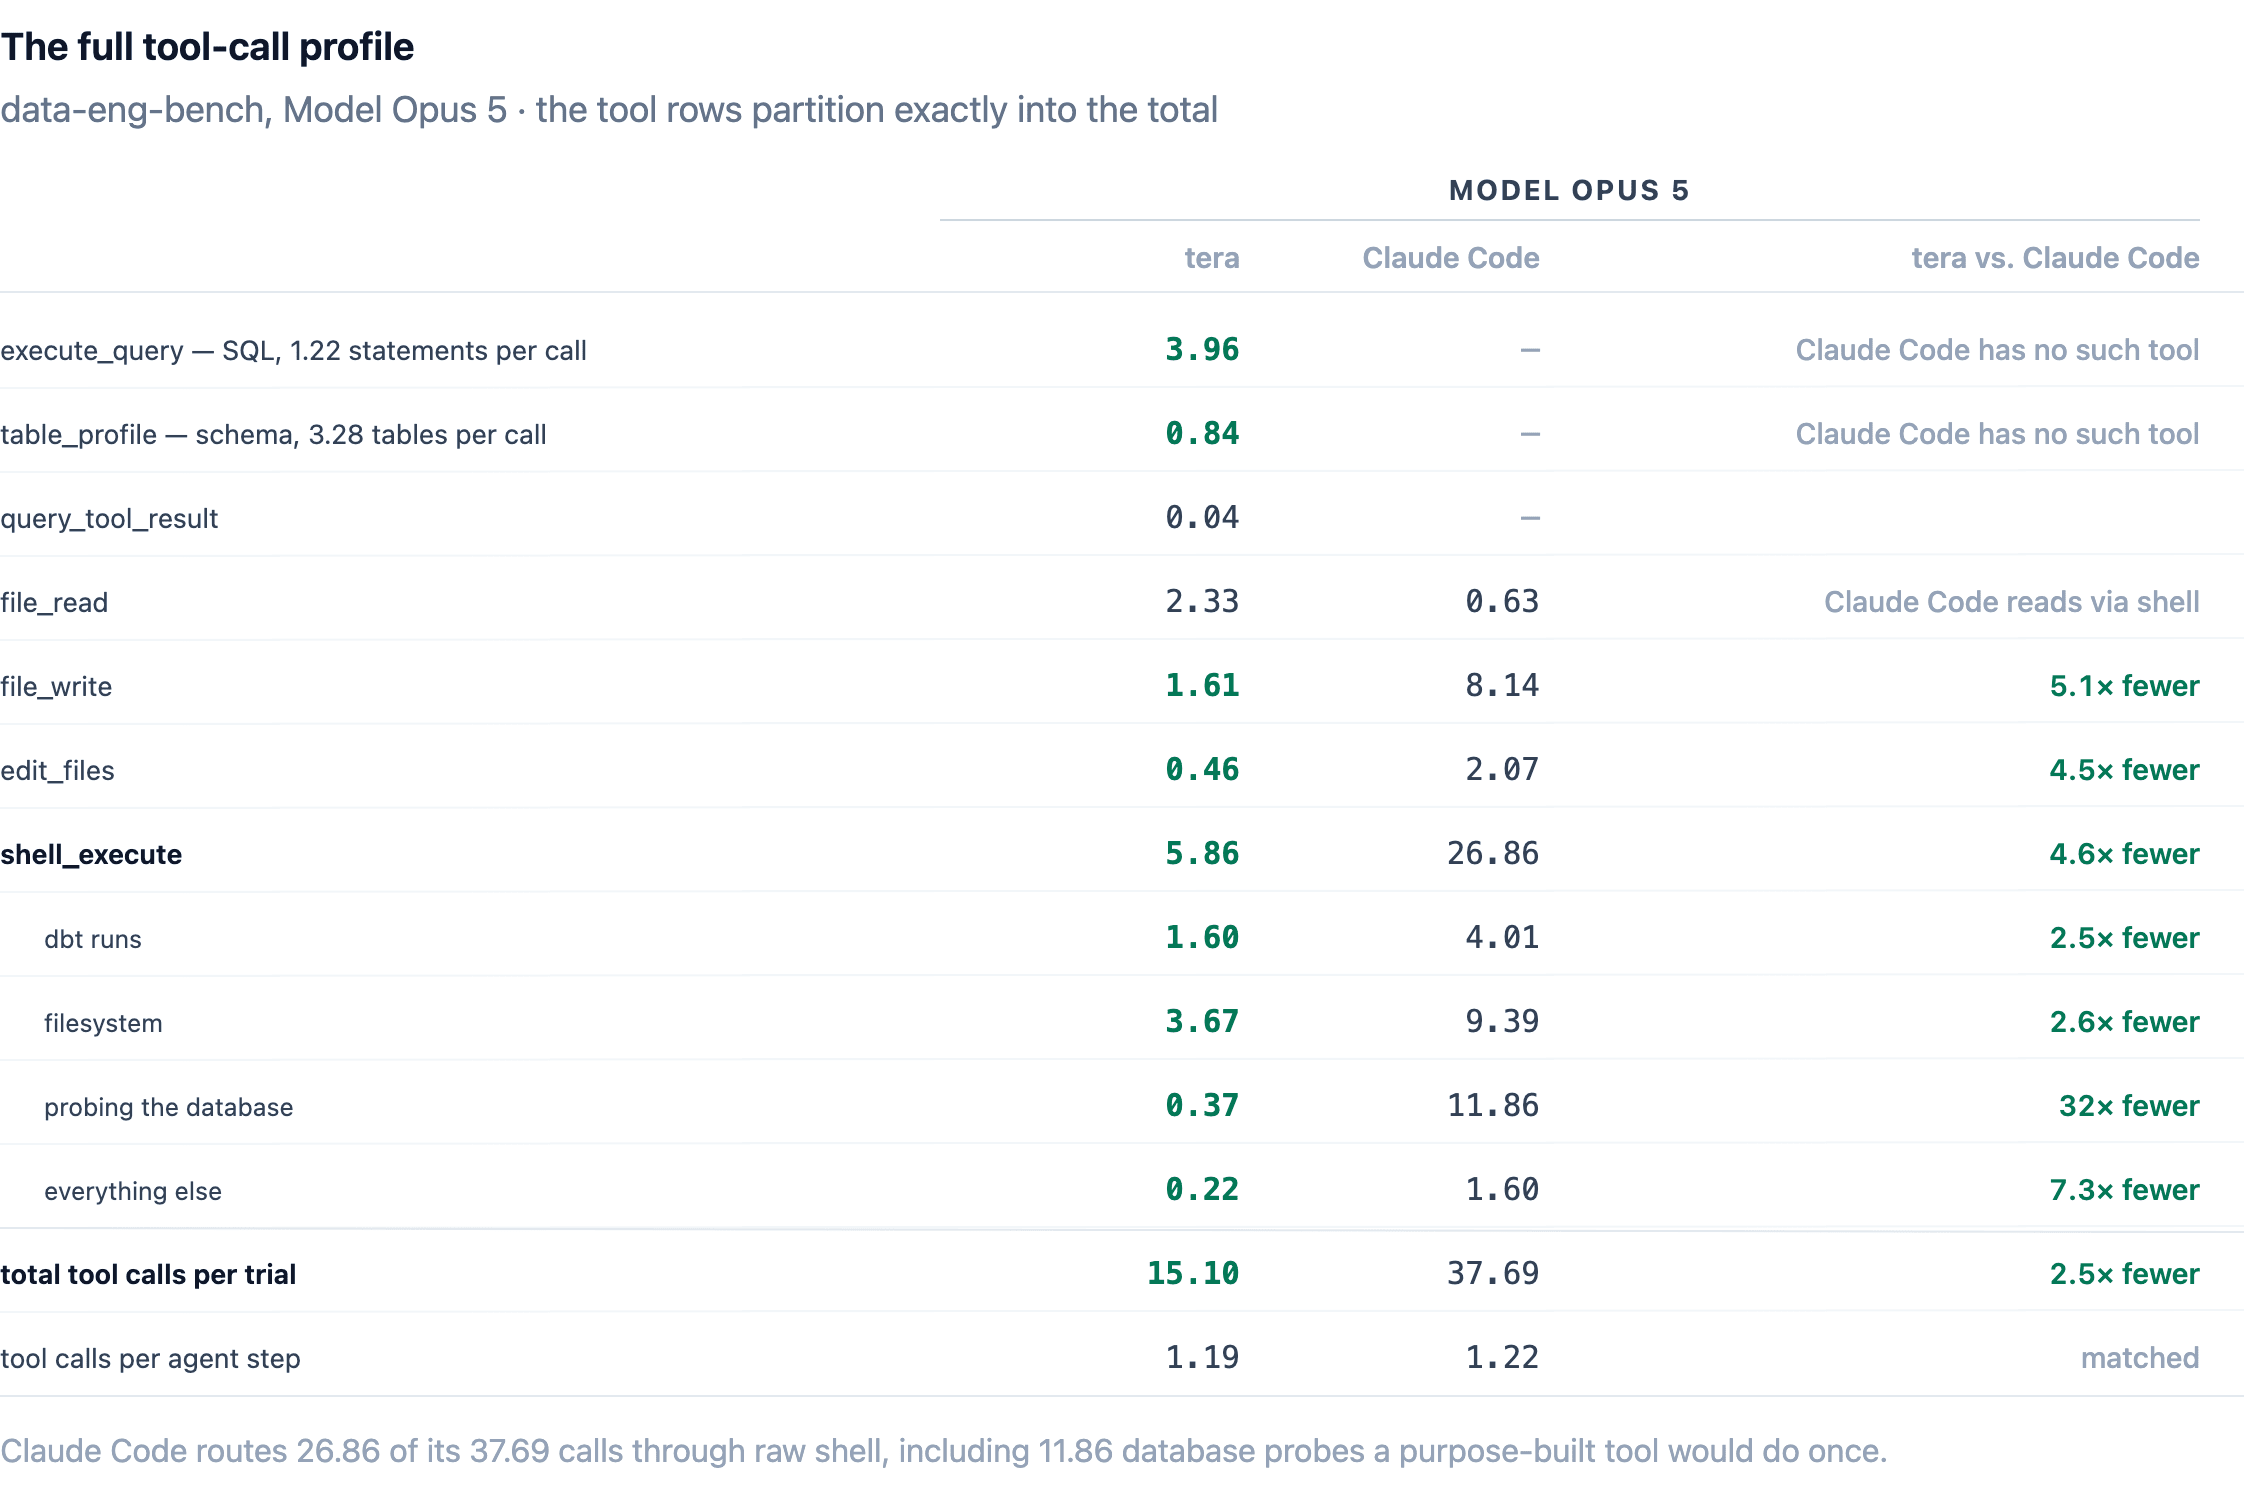
LLMの1ターンあたりのツール呼び出し数は同等です(1.19回 対 1.22回)。両エージェントとも、LLMの1ターンあたり約1.2回のツール呼び出しを行っています。TeraがClaude Codeを凌駕している理由は、1ターンに多くのツールを無理やり詰め込んでいるからではなく、目的特化型の呼び出し1回がシェルの調査3〜5回分を代替するため、必要なターン数そのものが少なくて済むからです。
無駄を削ぎ落としたツールインターフェース、初期段階での集中的な探索、ウェアハウスへの処理プッシュダウンなど、Teraのハーネスにおけるすべての設計は、ただ1つの測定可能な成果のために従属しています。